Warum die meisten Firmen-Chatbots Antworten erfinden – und wie wir einen gebaut haben, der seine Quellen nennt
Ein Blick hinter die Kulissen von AIVCJ Knowledge: hybride Suche, Abfrageplanung, eine Faktenprüfung jeder Antwort und zwei öffentliche Testsets – darunter ein Blind-Set, geschrieben so, wie echte Menschen tippen. Live testen mit Beispieldokumenten aus HR, Produkt und GST – oder mit Ihrem eigenen PDF.
Jedes Unternehmen hat dasselbe Problem. Die Antworten gibt es – in einer Urlaubsrichtlinie, einem Garantie-PDF, einer Arbeitsanweisung von 2023 –, aber niemand findet sie. Also fragt man eine Kollegin, rät oder eröffnet ein Ticket. Ein Chatbot wirkt wie die naheliegende Lösung. Die meisten enttäuschen aus einem Grund: Sie antworten selbstsicher, auch wenn sie es nicht wissen, und niemand kann prüfen, woher eine Antwort stammt.
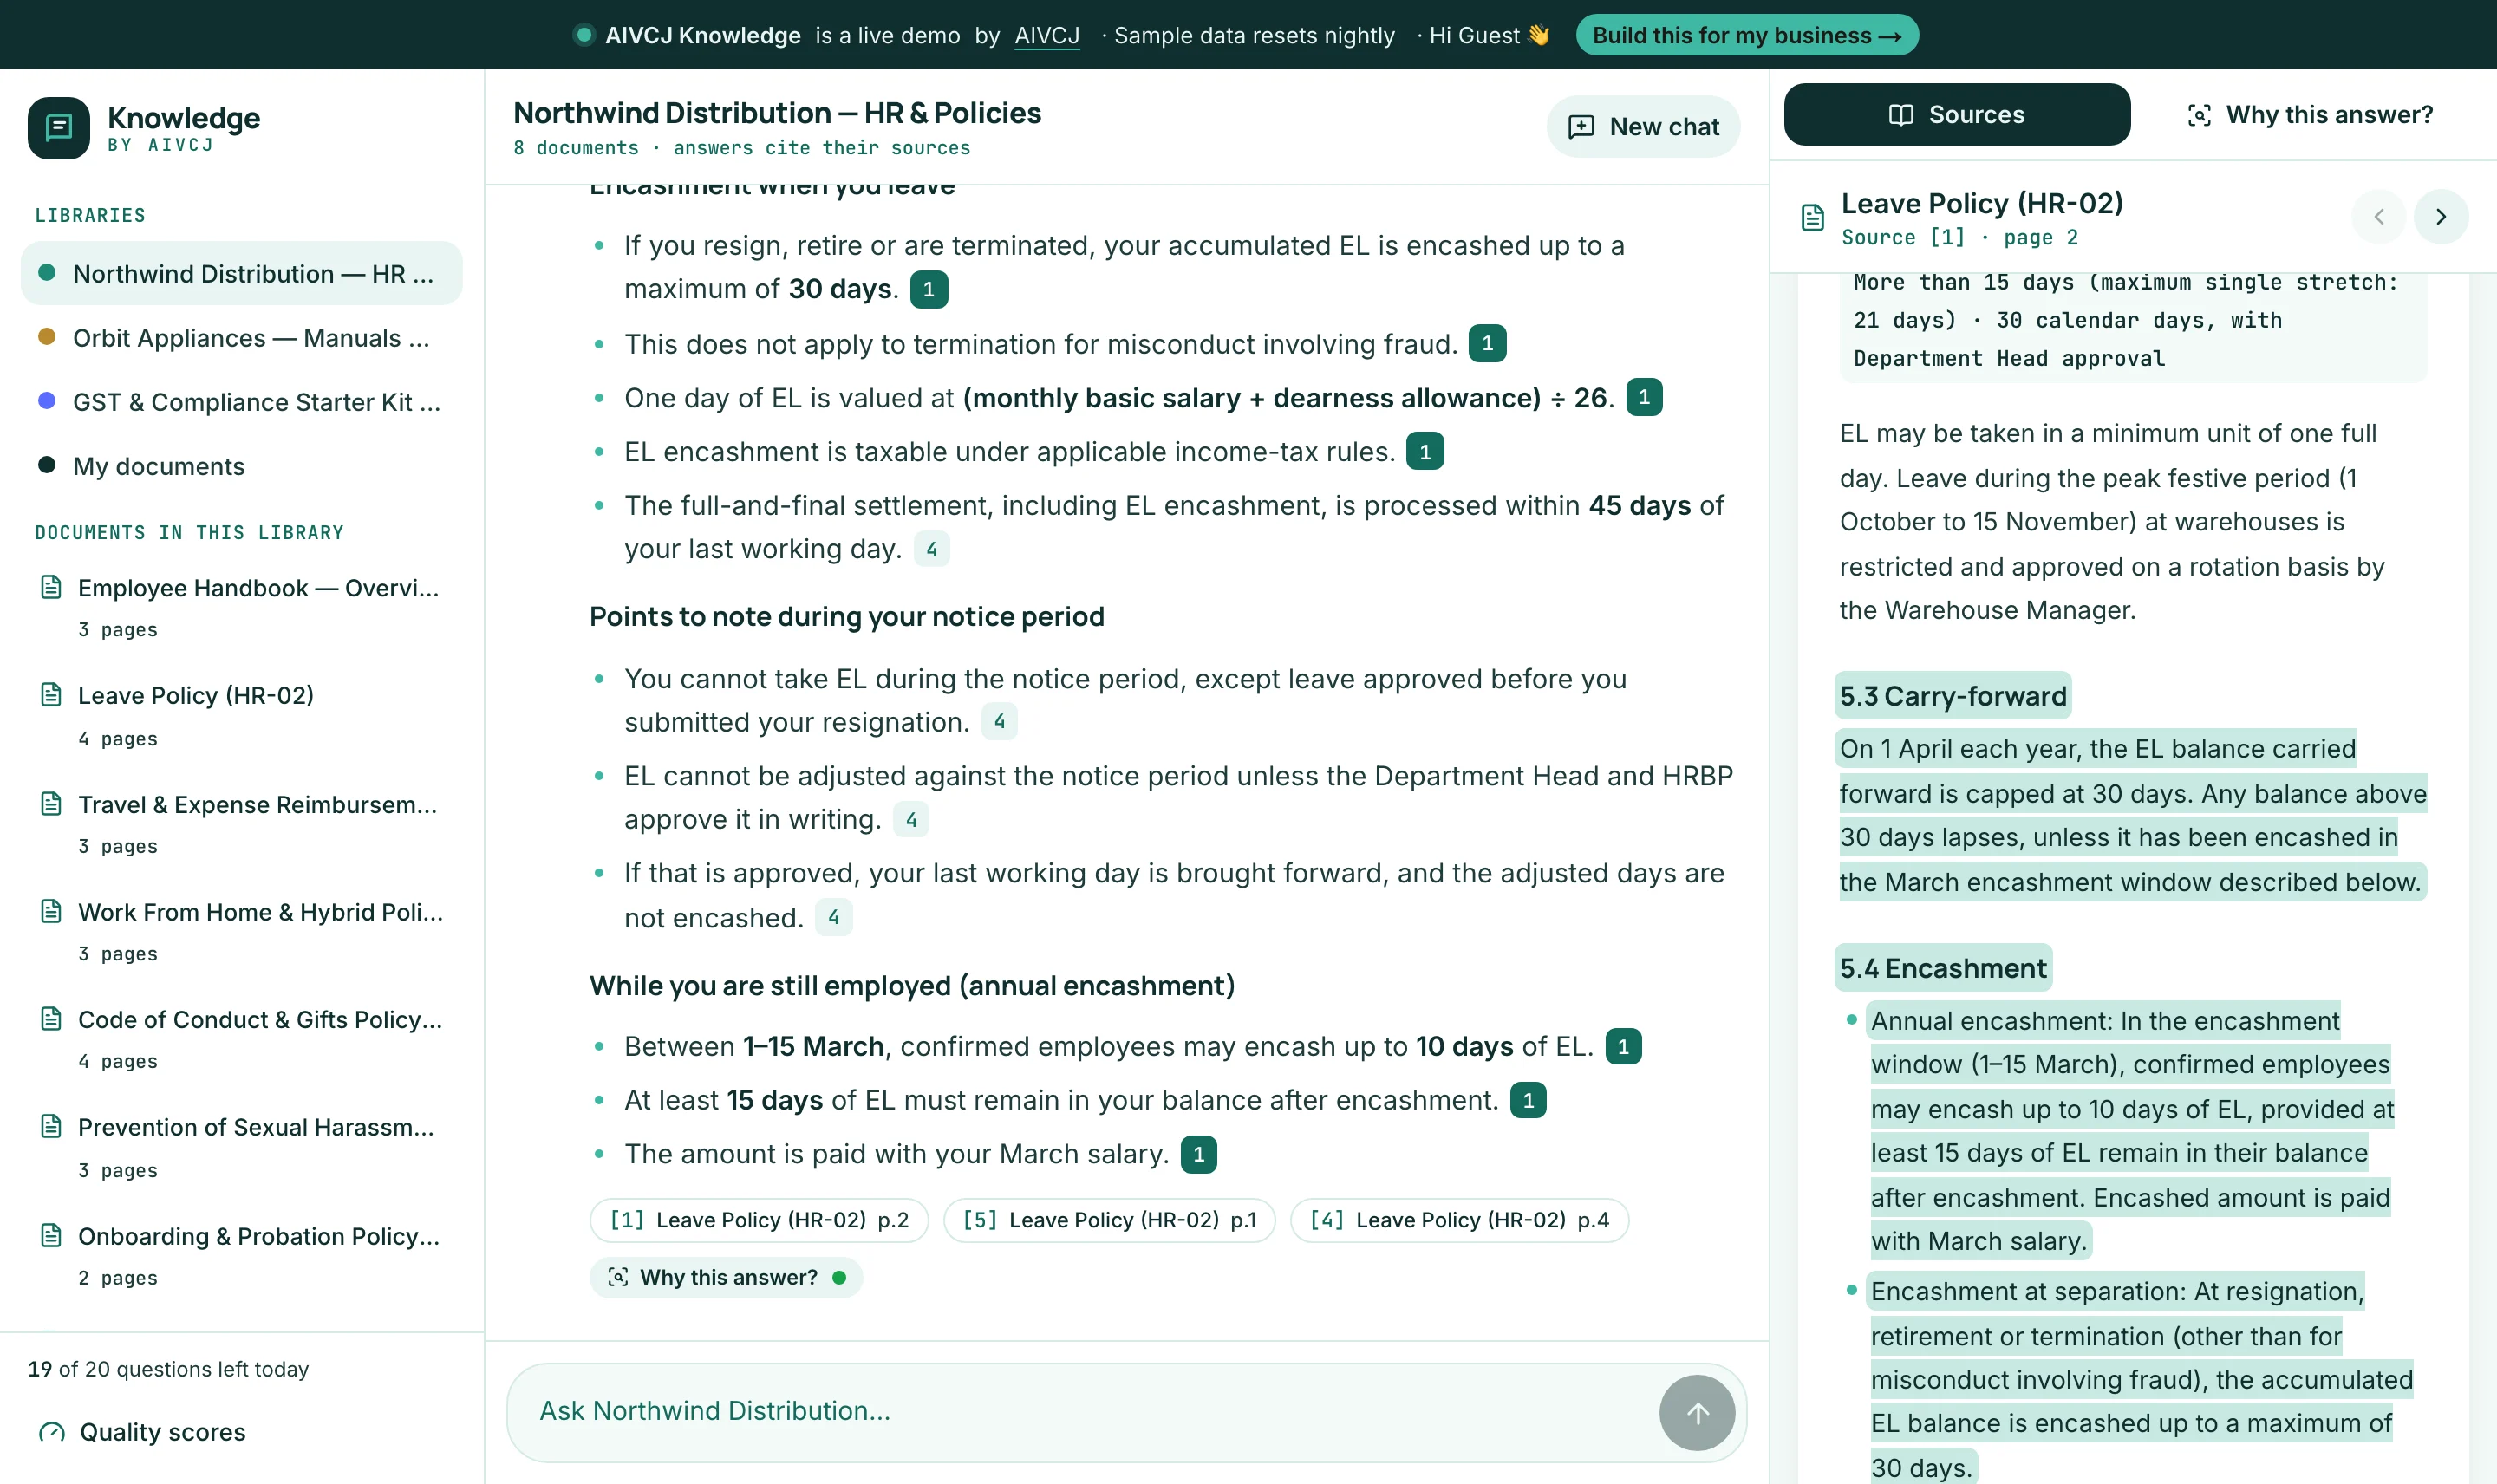
Wir haben AIVCJ Knowledge gebaut, um zu zeigen, wie die Alternative aussieht. Es ist eine Live-Demo, die Sie heute öffnen können: Wählen Sie eine Beispielbibliothek, stellen Sie eine echte Frage, und jeder Satz der Antwort verweist auf die genaue Textstelle, aus der er stammt.
Das Problem: flüssig ist nicht gleich richtig
Ein Sprachmodell allein antwortet aus dem Gedächtnis. Fragen Sie es nach Ihrer Regel zur Übertragung von Resturlaub, und es erzeugt etwas Plausibles aus den Richtlinien Tausender anderer Unternehmen. Einfache Suche (RAG) hilft, aber naive Varianten scheitern auf vorhersehbare Weise:
- Mehrteilige Fragen. „Ich bin vor zwei Monaten in die Finanzabteilung gekommen – darf ich zwei Tage pro Woche im Homeoffice arbeiten?“ braucht die Hybrid-Richtlinie und die Probezeitregel. Eine einzelne Suche findet selten beides.
- Tabellen und Überschriften werden getrennt. Zerschneiden Sie ein Dokument alle 900 Zeichen, landet die Spesentabelle getrennt von der Überschrift, die sagt, worum es geht.
- Kein ehrliches „Weiß ich nicht“. Wird die richtige Textstelle nicht gefunden, füllt das Modell die Lücke.
- Keine Möglichkeit zur Prüfung. Ohne Quellenangaben sieht eine falsche Antwort genauso aus wie eine richtige.
So funktioniert AIVCJ Knowledge
- Strukturbewusste Aufnahme. Dokumente (PDF, DOCX, TXT) werden entlang ihrer eigenen Struktur zerlegt: Überschriften bleiben bei ihrem Inhalt, Tabellen bleiben ganz, und jede Textstelle merkt sich ihr Dokument und ihren Abschnitt. Dieser Kontext wird mit eingebettet, sodass auch eine Tabellenzeile noch „weiß“, dass sie zum Spesenabschnitt der Reiserichtlinie gehört.
- Abfrageplanung. Ein kleines, schnelles Modell zerlegt jede Frage in die benötigten Einzelfakten – die Gehaltsstufe der Person, die Kategorie der Stadt, die Spesentabelle – und jedes davon wird zu einer eigenen Suche.
- Hybride Suche. Jede Suche läuft in PostgreSQL auf zwei Wegen: nach Bedeutung (pgvector-Embeddings) und nach exakten Wörtern (Volltextsuche). Die Ergebnisse werden per Reciprocal-Rank-Fusion zusammengeführt, und jeder Teil der Frage bekommt einen festen Platz.
- Antworten nur aus den Quellen. Claude schreibt die Antwort ausschließlich aus den gefundenen Textstellen und belegt jede Aussage mit [1], [2] … Wenn die Dokumente etwas nicht abdecken, sagt es das klar.
- Faktenprüfung. Ein zweiter Durchgang vergleicht die fertige Antwort mit ihren Quellen und kennzeichnet sie als vollständig belegt, teilweise belegt oder nicht in den Dokumenten – sichtbar für die Nutzer.
Was Sie in der Demo sehen
- Anklickbare Quellenangaben, die die Quellseite mit hervorgehobener Textstelle öffnen.
- „Warum diese Antwort?“ – jede gefundene Textstelle mit ihren Bedeutungs-, Stichwort- und Fusionswerten, welche zitiert wurden, das Ergebnis der Faktenprüfung, die benötigte Zeit und die verbrauchten Tokens.
- Ihr eigenes Dokument. Laden Sie ein PDF oder Word-Dokument hoch (nur für Sie sichtbar, jede Nacht gelöscht) und stellen Sie innerhalb von Sekunden Fragen dazu.
- Eine Qualitätsseite mit allen Testergebnissen, Frage für Frage.
Gemessen statt geschätzt – und ehrlich zu den Grenzen
Jede Beispielbibliothek hat zwei Testsets, und jede Antwort wird auf Quellentreue und Relevanz für die Frage geprüft.
- Golden-Set (45 Fragen). Zusammen mit den Dokumenten geschrieben, einschließlich Fragen über mehrere Dokumente und Fragen, die die Dokumente bewusst nicht beantworten. Wir haben es beim Feintuning verwendet, es schmeichelt uns also. Unsere erste Version – Abschnitte fester Länge und eine einzige Suche pro Frage – erreichte 40 von 45 bei 91–93 % Quellentreue; alle Fehler betrafen mehrteilige Fragen. Strukturbewusstes Zerlegen, kontextbezogene Embeddings und Abfrageplanung brachten es auf 42–45 von 45 je nach Lauf, bei 98–100 % Quellentreue.
- Blind-Set (20 Fragen). Später von einer anderen Person geschrieben, so wie Menschen wirklich tippen – Hinglish, Tippfehler, vage Formulierungen, Fragen, die zwei Dokumente brauchen – und nie fürs Tuning verwendet: 19–20 von 20 je nach Lauf, bei 95–96 % Quellentreue. Der Fehler in einem Lauf ist lehrreich: Auf die Frage (auf Hinglish), was zu tun ist, wenn man einen Firmenlaptop im Taxi vergessen hat, nannte es den normalen IT-Helpdesk statt der rund um die Uhr erreichbaren IT-Sicherheitshotline und ließ den Schritt mit der Polizeianzeige weg – genau die Art Lücke, für deren Entdeckung es ein Blind-Set gibt.
Zwei Einschränkungen, die wir lieber offen nennen: Bewertet wird von einem KI-Prüfer (Claude) anhand von Referenzantworten – aus derselben Modellfamilie wie der Assistent –, und die Ergebnisse sind nicht von Menschen geprüft; außerdem sind unsere Beispieldokumente sauberer als die meisten echten Firmendateien. Nehmen Sie die Zahlen als Richtwerte. Jede Frage, Antwort und Bewertung ist auf der Qualitätsseite öffentlich.
Ebenso wichtig: Fragen, die die Dokumente nicht abdecken, bekommen ein ehrliches „Das habe ich in den Dokumenten nicht gefunden“ – keine Erfindung.
Diese Disziplin bringen wir in Kundenprojekte ein: ein Testset echter Fragen ab dem ersten Tag, das bei jeder Änderung von Prompt, Modell oder Dokument erneut läuft, damit Qualität eine Zahl ist, die man verfolgen kann – kein Bauchgefühl.
Einsatz mit Ihren Daten
Die Demo läuft auf dem Stack, den wir für Kunden einsetzen: Next.js, PostgreSQL mit pgvector und Claude, auf der Infrastruktur Ihrer Wahl – auch auf Ihren eigenen Servern für sensible Dokumente. Ein typisches Projekt beginnt mit einem Ablauf mit hohem Volumen (HR-Fragen, Produktsupport oder interne Arbeitsanweisungen), fünfzig echten Fragen und einem gemessenen Pilotprojekt in Wochen statt Monaten. Mit dem Wachstum kommen Konnektoren (Google Drive, SharePoint, Notion), Rechte pro Dokument und ein WhatsApp-Kanal hinzu.
- #RAG
- #Case study
- #pgvector
- #Claude
- #Evaluation
Häufig gestellte Fragen
01Funktioniert es mit unseren eigenen Dokumenten?
02Was passiert, wenn die Antwort nicht in den Dokumenten steht?
03Kann es auf unseren eigenen Servern laufen?
KI- & RAG-Anwendungen
Assistenten, die aus Ihren Daten antworten – und sie zitieren.
Weiterlesen
 ERP & Betrieb
5 Min. Lesezeit
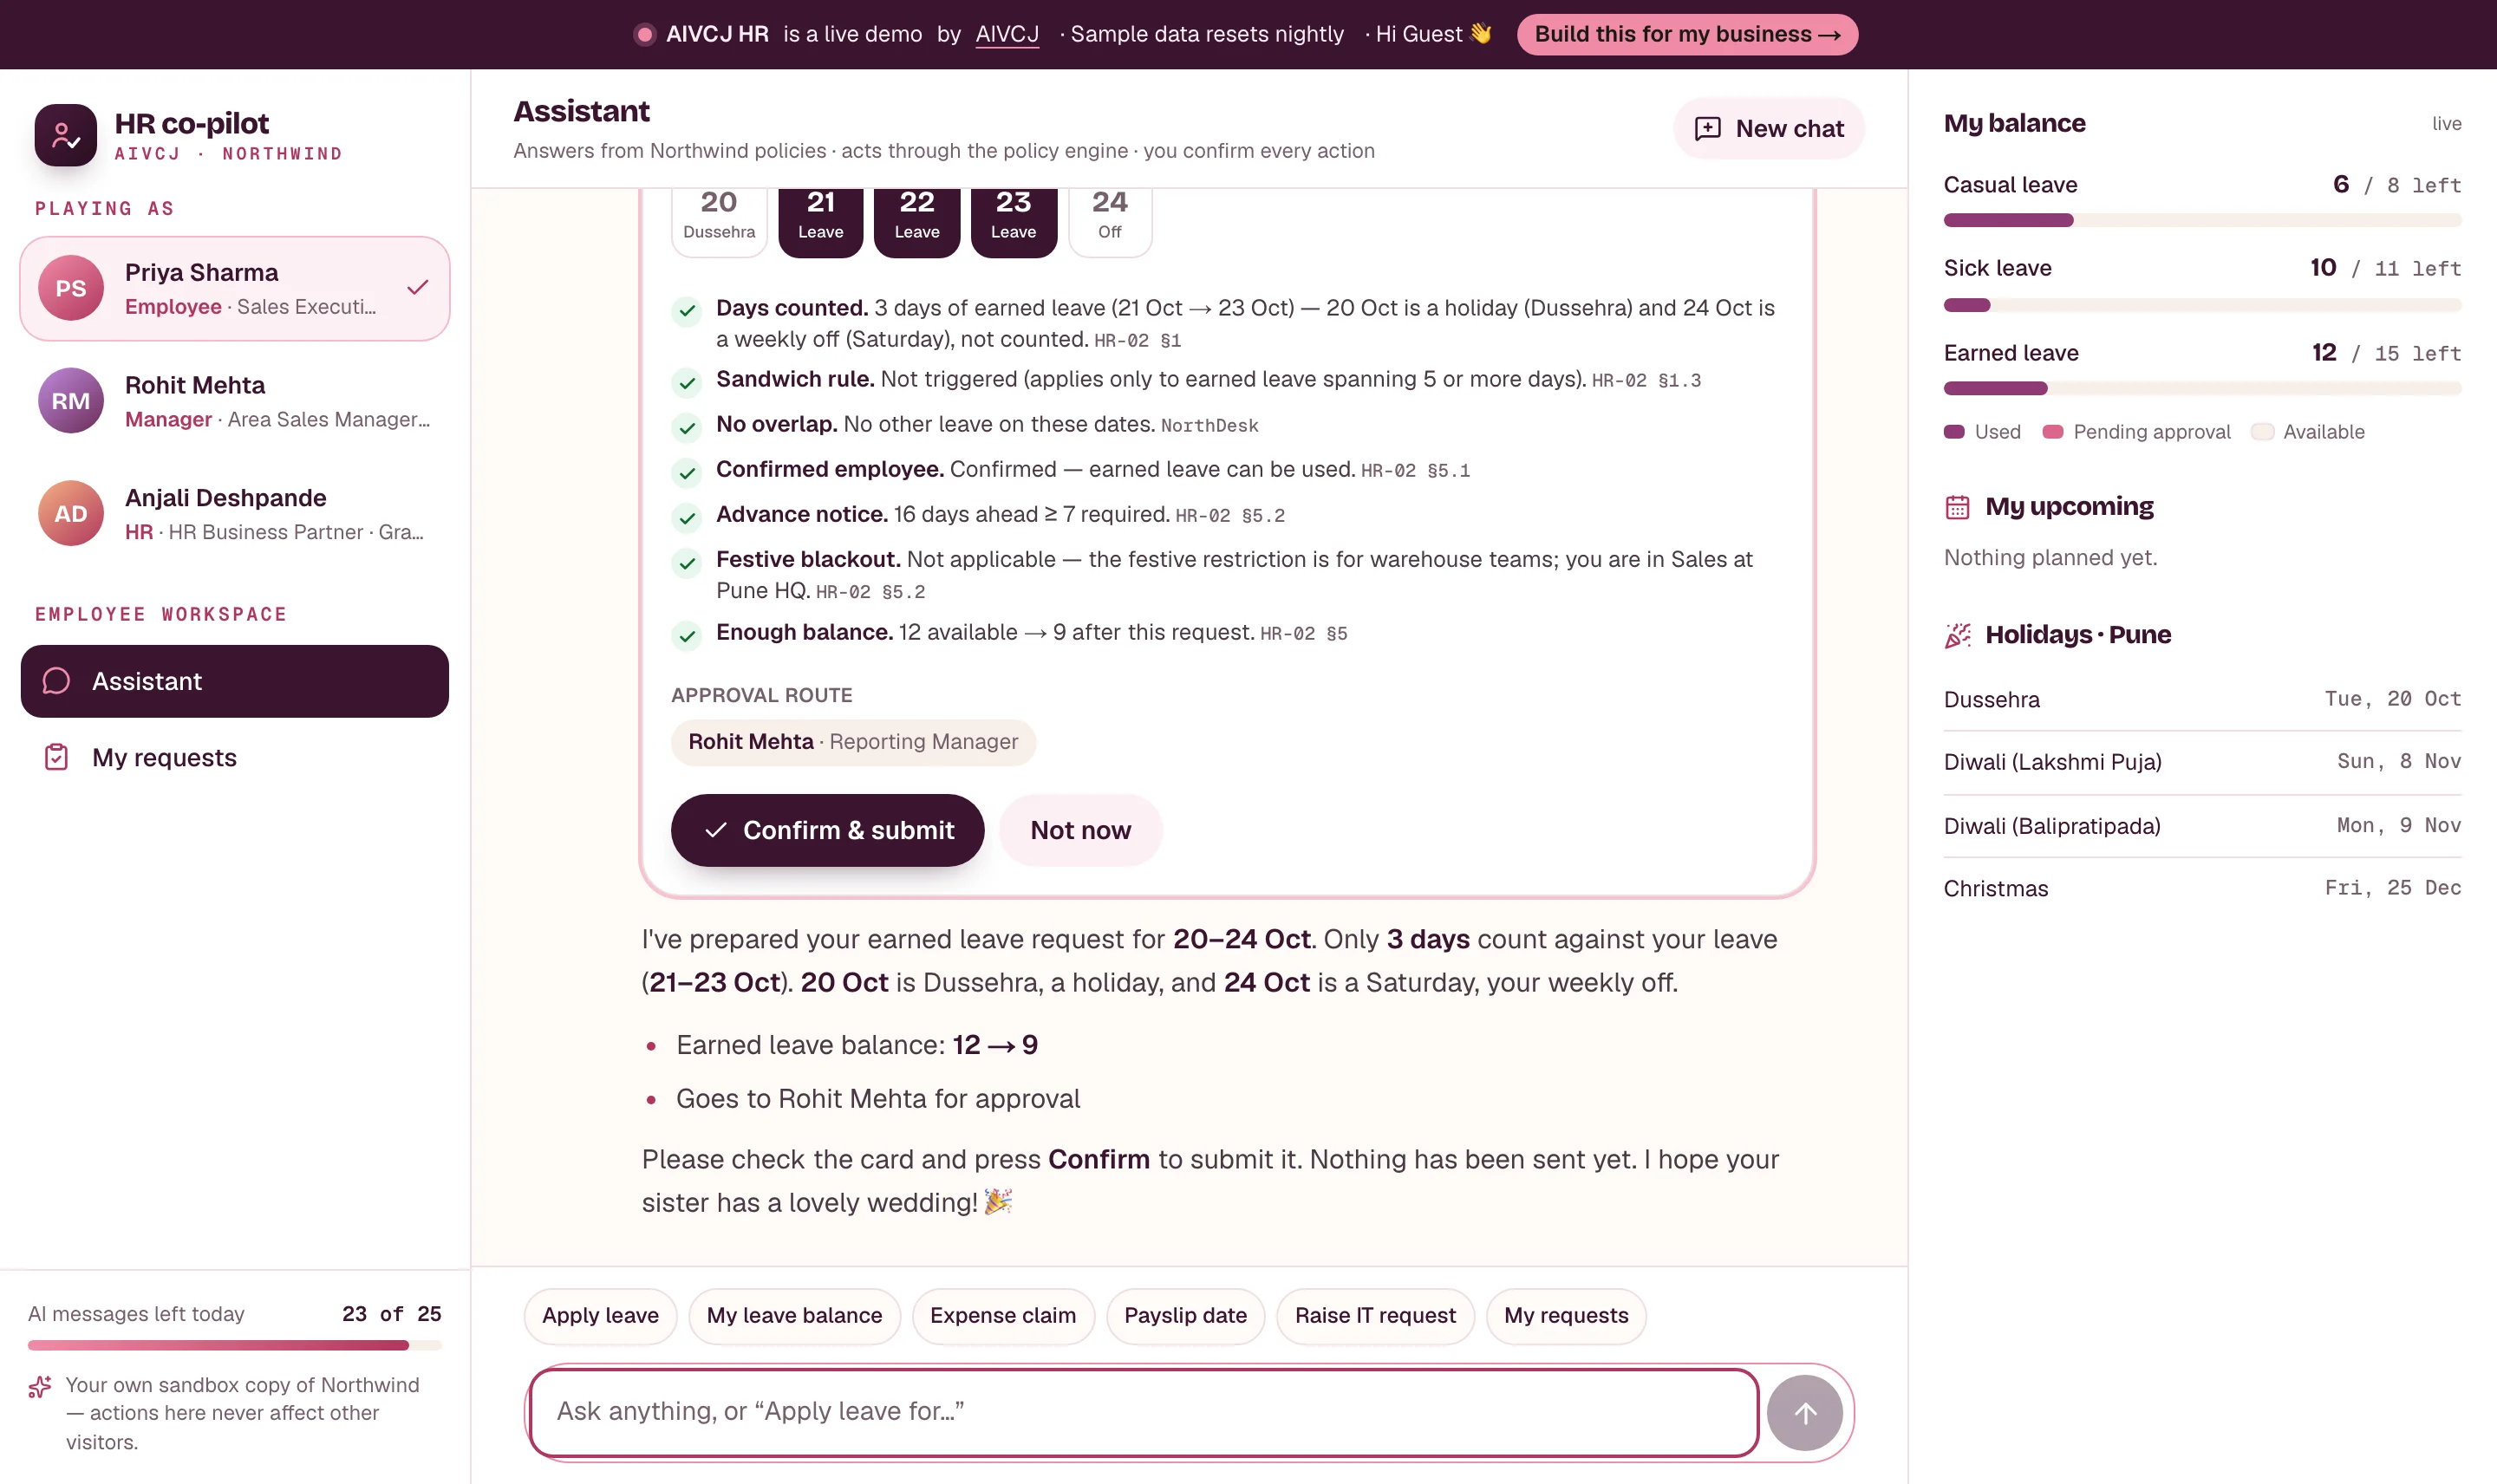
Vom Chatbot zum Kollegen: ein HR-Assistent, der sicher handelt
AIVCJ HR beantwortet nicht nur Urlaubsfragen – er beantragt Urlaub, leitet Genehmigungen weiter und entwirft HR-Schreiben. So haben wir eine KI handeln lassen, ohne sie die Regeln machen zu lassen: eine Policy-Engine im Code, eine Bestätigungskarte vor jeder Aktion, Rollenrechte und ein Audit-Log. Gemessen an einem geskripteten und einem Blind-Testset.
Weiterlesen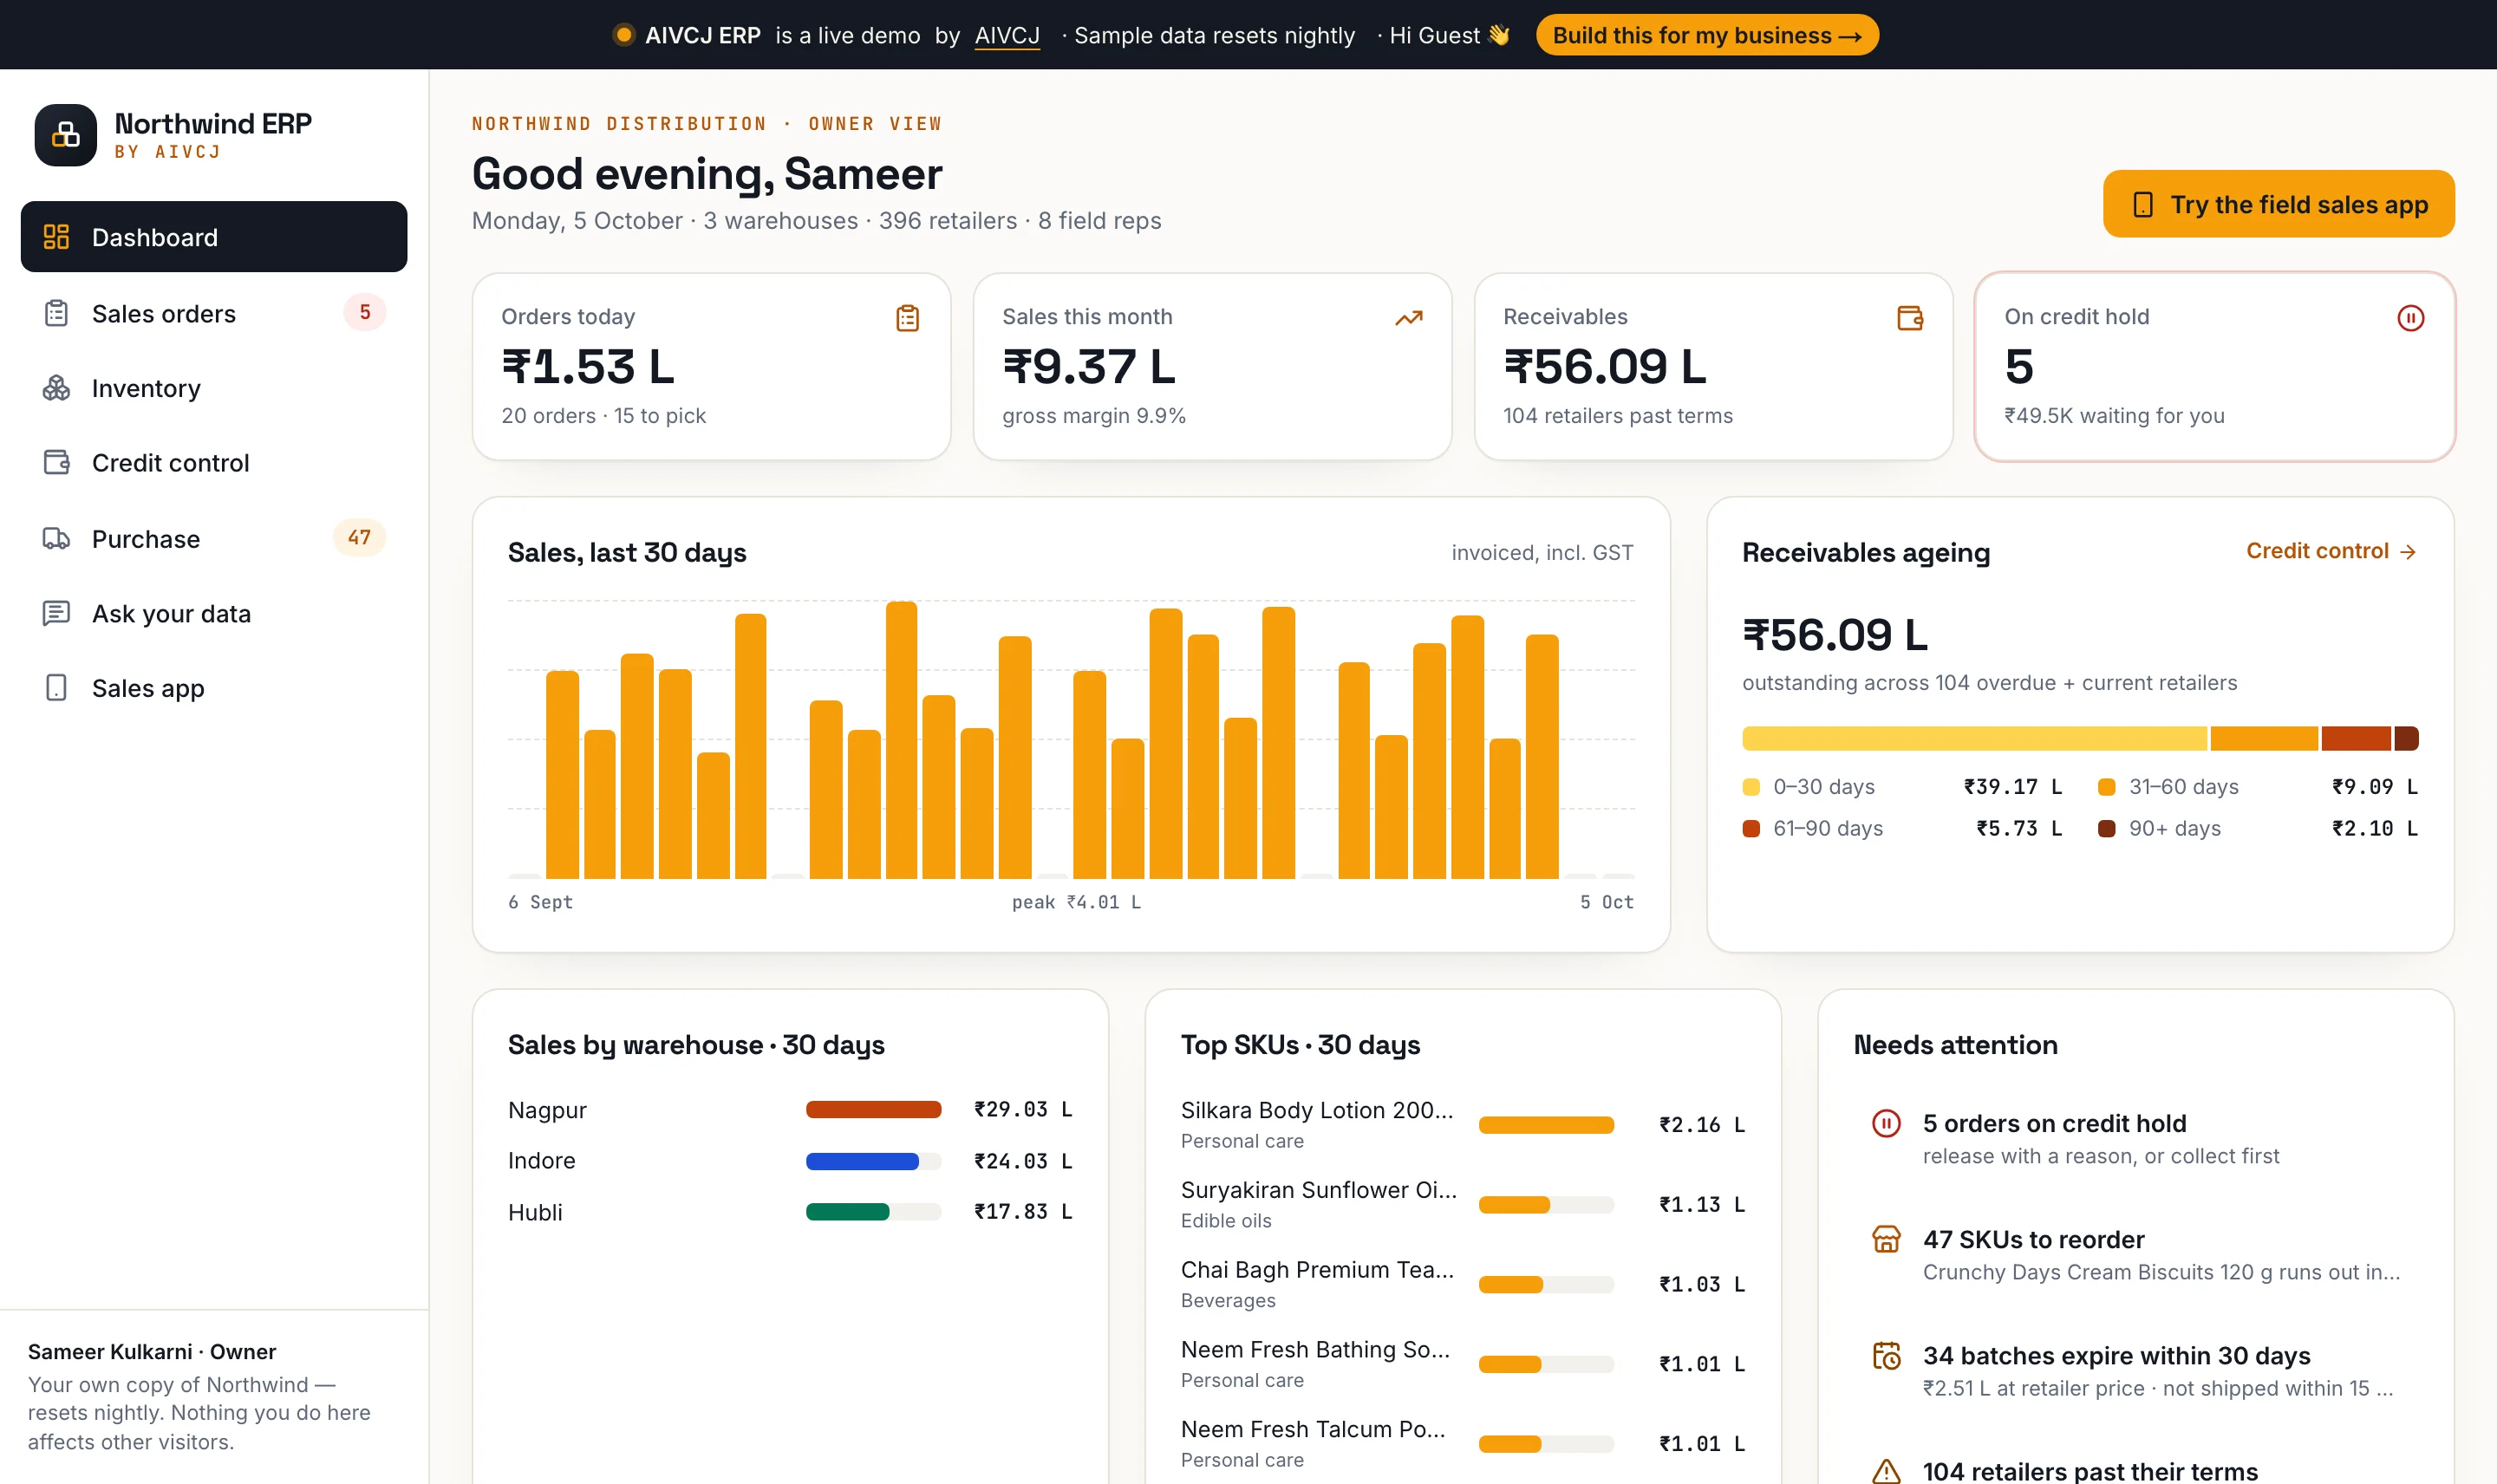 ERP & Betrieb
6 Min. Lesezeit
Von WhatsApp-Fotos zum Live-Auftragsbuch: ein ERP und eine Offline-Außendienst-App für Distributoren
AIVCJ ERP ersetzt den Kreislauf aus Tally, Excel und WhatsApp: eine Außendienst-App, die Aufträge ohne Netz aufnimmt und nie doppelt synchronisiert, Kreditsperren, die im Code entschieden werden, FEFO-Kommissionierung mit GST-Rechnungen und Fragen in Alltagssprache, beantwortet durch eine sichtbare Nur-Lese-Abfrage. Gemessen mit einem Synchronisationstest auf zwei Handys und einem Blindtest für NL-zu-SQL.
Weiterlesen2 Min. Lesezeit
Was ist RAG – und wann braucht Ihr Unternehmen es wirklich?
Mit Retrieval-Augmented Generation antwortet KI aus Ihren eigenen Dokumenten, statt zu raten. So funktioniert es, hier glänzt es – und daran erkennen Sie, dass Sie bereit dafür sind.
Weiterlesen