বেশিরভাগ কোম্পানির চ্যাটবট কেন উত্তর বানিয়ে ফেলে — আর আমরা কীভাবে উৎস দেখানো একটি চ্যাটবট বানালাম
AIVCJ Knowledge-এর পেছনের গল্প: হাইব্রিড রিট্রিভাল, কোয়েরি প্ল্যানিং, প্রতিটি উত্তরে গ্রাউন্ডিং যাচাই, আর দুটি পাবলিক টেস্ট সেট — যার একটি ব্লাইন্ড সেট সাধারণ মানুষ যেভাবে টাইপ করেন সেভাবে লেখা। নমুনা HR, প্রোডাক্ট ও GST নথিতে, বা আপনার নিজের PDF-এ লাইভ চেষ্টা করুন।
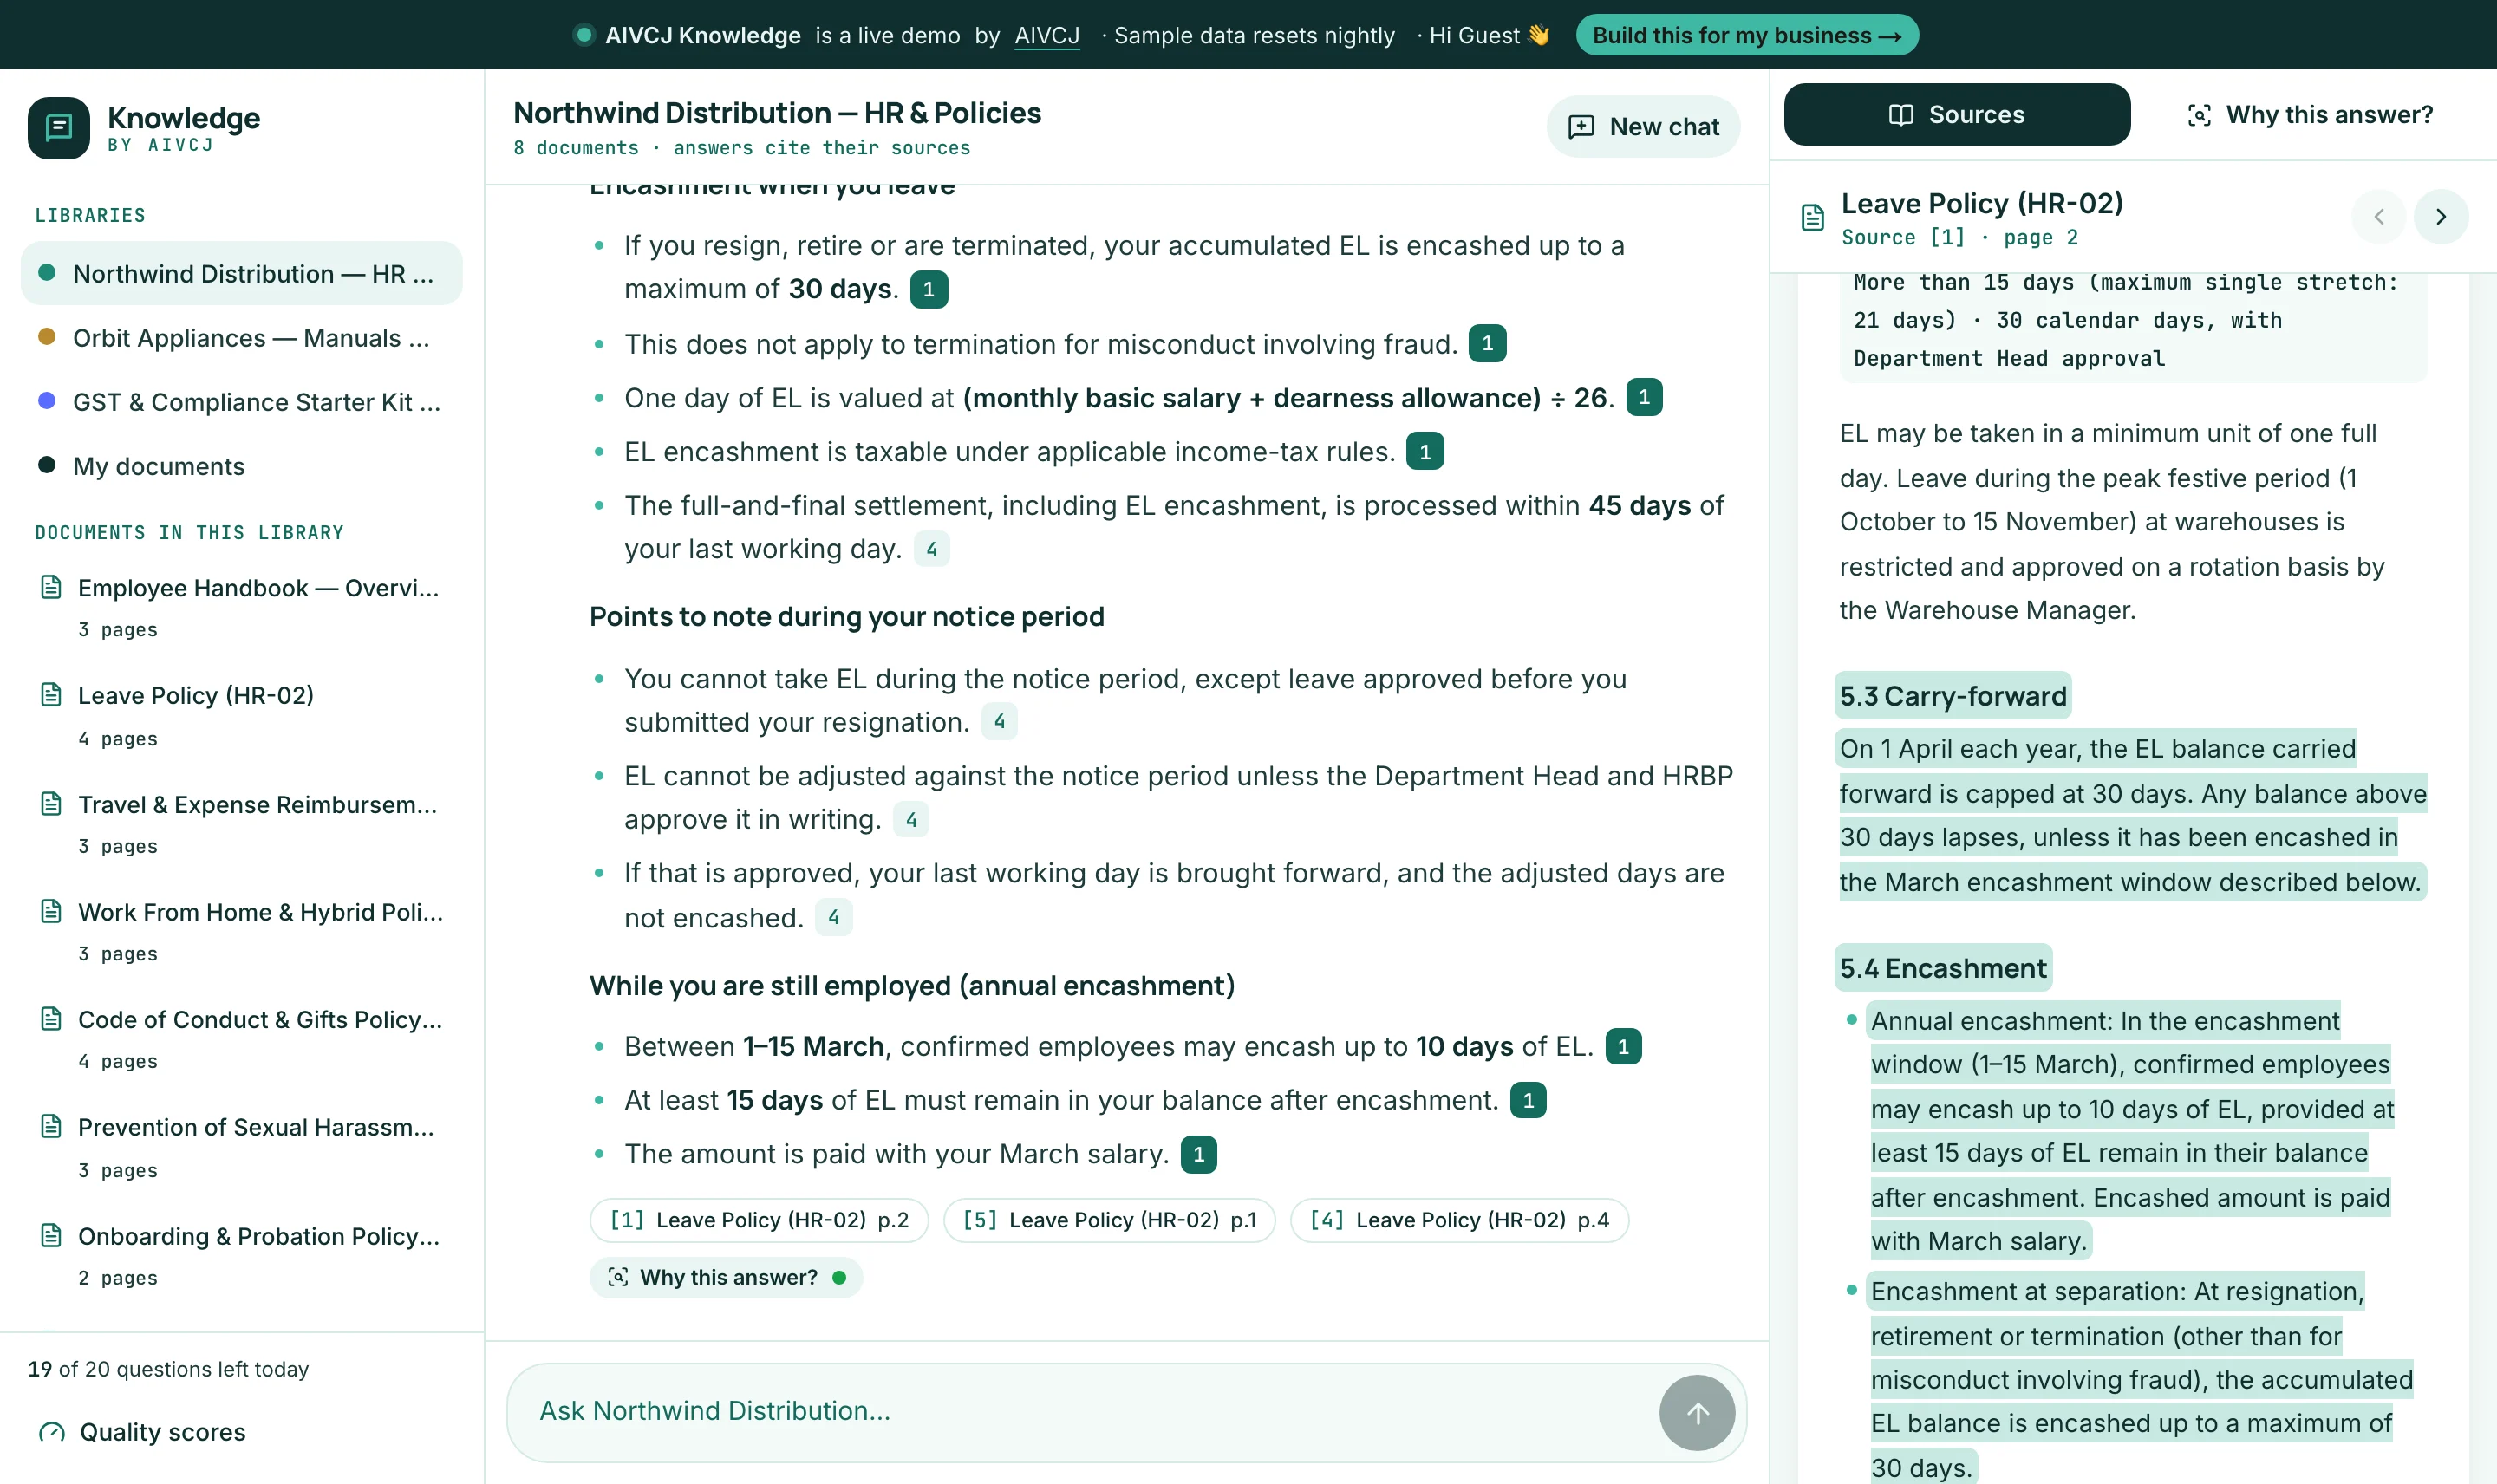
প্রতিটি কোম্পানির একই সমস্যা। উত্তর আছে — কোনো লিভ পলিসিতে, ওয়ারেন্টির PDF-এ, ২০২৩ সালের কোনো SOP-তে — কিন্তু কেউ খুঁজে পায় না, তাই মানুষ সহকর্মীকে জিজ্ঞেস করে, আন্দাজ করে, বা টিকিট খোলে। চ্যাটবটকে সহজ সমাধান মনে হয়। বেশিরভাগই একটি কারণে হতাশ করে: না জানলেও তারা আত্মবিশ্বাসের সঙ্গে উত্তর দেয়, আর উত্তর কোথা থেকে এল তা কেউ যাচাই করতে পারে না।
বিকল্পটা দেখতে কেমন, তা দেখাতে আমরা AIVCJ Knowledge বানিয়েছি। এটি একটি লাইভ ডেমো যা আজই খুলতে পারেন: একটি নমুনা লাইব্রেরি বাছুন, আসল প্রশ্ন করুন, আর উত্তরের প্রতিটি বাক্য যে অংশ থেকে এসেছে ঠিক সেটি দেখিয়ে দেয়।
সমস্যা: সাবলীল হওয়া মানেই সঠিক হওয়া নয়
একা একটি ভাষা মডেল স্মৃতি থেকে উত্তর দেয়। আপনার ছুটি ক্যারি-ফরওয়ার্ডের নিয়ম জিজ্ঞেস করুন, আর এটি হাজারো অন্য কোম্পানির পলিসি থেকে বিশ্বাসযোগ্য কিছু বানিয়ে ফেলবে। সাধারণ রিট্রিভাল (RAG) সাহায্য করে, কিন্তু সরল সংস্করণগুলো অনুমানযোগ্যভাবে ব্যর্থ হয়:
- একাধিক অংশের প্রশ্ন। “দুই মাস আগে Finance-এ যোগ দিয়েছি — আমি কি সপ্তাহে দুদিন বাড়ি থেকে কাজ করতে পারি?” — এর জন্য হাইব্রিড পলিসি এবং প্রোবেশনের নিয়ম দুটোই লাগে। একটি সার্চ কোয়েরি কদাচিৎ দুটোই খুঁজে পায়।
- টেবিল আর হেডিং আলাদা হয়ে যায়। নথিকে প্রতি ৯০০ অক্ষরে কাটুন, অ্যালাউন্স টেবিলটি যে হেডিং বলে দেয় সেটা কী নিয়ে, তার থেকে আলাদা হয়ে যায়।
- সৎ “জানি না” নেই। সঠিক অংশ না পেলে মডেল ফাঁকটা নিজেই ভরিয়ে দেয়।
- যাচাইয়ের উপায় নেই। উদ্ধৃতি ছাড়া ভুল উত্তর দেখতে হুবহু সঠিক উত্তরের মতো।
AIVCJ Knowledge কীভাবে কাজ করে
- কাঠামো বুঝে ইনজেশন। নথি (PDF, DOCX, TXT) তাদের নিজস্ব কাঠামো ধরে ভাগ হয়: হেডিং তার বিষয়বস্তুর সঙ্গে থাকে, টেবিল অখণ্ড থাকে, আর প্রতিটি অংশ মনে রাখে সে কোন নথি ও কোন সেকশনের। এই প্রসঙ্গ অংশের সঙ্গে এমবেড হয়, ফলে টেবিলের একটি সারিও “জানে” যে সে ট্রাভেল পলিসির অ্যালাউন্স সেকশনের।
- কোয়েরি প্ল্যানিং। একটি ছোট, দ্রুত মডেল প্রতিটি প্রশ্নকে প্রয়োজনীয় আলাদা তথ্যে ভাগ করে — কর্মীর গ্রেড, শহরের টিয়ার, অ্যালাউন্স টেবিল — আর প্রতিটি আলাদা সার্চ হয়।
- হাইব্রিড রিট্রিভাল। প্রতিটি সার্চ PostgreSQL-এর ভেতরে দুভাবে চলে: অর্থ ধরে (pgvector এমবেডিং) আর হুবহু শব্দ ধরে (ফুল-টেক্সট সার্চ)। ফলগুলো reciprocal-rank fusion দিয়ে মেলানো হয়, আর প্রশ্নের প্রতিটি অংশ একটি জায়গার নিশ্চয়তা পায়।
- কেবল উৎস থেকে উত্তর। Claude কেবল খুঁজে পাওয়া অংশ থেকে উত্তর লেখে, প্রতিটি দাবিতে [1], [2]… উদ্ধৃতি দিয়ে। নথিতে না থাকলে সেটা স্পষ্ট বলে দেয়।
- গ্রাউন্ডিং যাচাই। দ্বিতীয় একটি ধাপ তৈরি উত্তরকে তার উৎসের সঙ্গে মিলিয়ে সম্পূর্ণ সমর্থিত, আংশিক সমর্থিত বা নথিতে নেই হিসেবে চিহ্নিত করে — যা ব্যবহারকারী দেখতে পান।
ডেমোতে যা দেখবেন
- ক্লিকযোগ্য উদ্ধৃতি যা উৎস পাতা খুলে হুবহু অংশটি হাইলাইট করে।
- “এই উত্তর কেন?” — খুঁজে পাওয়া প্রতিটি অংশ তার অর্থ, কীওয়ার্ড ও ফিউশন স্কোরসহ, কোনগুলো উদ্ধৃত হয়েছে, গ্রাউন্ডিংয়ের রায়, কত সময় লেগেছে আর কত টোকেন খরচ হয়েছে।
- আপনার নিজের নথি। একটি PDF বা Word ফাইল আপলোড করুন (কেবল আপনার জন্য, প্রতি রাতে মুছে যায়) আর কয়েক সেকেন্ডে সেটি নিয়ে প্রশ্ন করুন।
- একটি কোয়ালিটি পাতা যেখানে প্রশ্ন ধরে ধরে পুরো টেস্টের ফল।
আন্দাজ নয়, মাপা — আর সীমা নিয়ে সৎ
প্রতিটি নমুনা লাইব্রেরির দুটি টেস্ট সেট আছে, আর প্রতিটি উত্তর উৎসের প্রতি বিশ্বস্ততা ও প্রশ্নের সঙ্গে প্রাসঙ্গিকতায় যাচাই হয়।
- গোল্ডেন সেট (৪৫টি প্রশ্ন)। নথির সঙ্গে লেখা, যাতে একাধিক নথির প্রশ্ন এবং এমন প্রশ্নও আছে যার উত্তর নথিতে ইচ্ছাকৃতভাবে নেই। টিউনিংয়ে আমরা এটি ব্যবহার করেছি, তাই এটি আমাদের একটু বেশি ভালো দেখায়। আমাদের প্রথম সংস্করণ — নির্দিষ্ট মাপের টুকরো আর প্রতি প্রশ্নে একটি সার্চ — ৪৫-এ ৪০ পেয়েছিল, ৯১–৯৩% বিশ্বস্ততায়; সব ভুল ছিল একাধিক অংশের প্রশ্নে। কাঠামো-ভিত্তিক টুকরো, প্রসঙ্গসহ এমবেডিং আর কোয়েরি প্ল্যানিং এটিকে বিভিন্ন রানে ৪৫-এ ৪২–৪৫, ৯৮–১০০% বিশ্বস্ততায় তুলেছে।
- ব্লাইন্ড সেট (২০টি প্রশ্ন)। পরে অন্য একজন লেখক লিখেছেন, মানুষ যেভাবে সত্যিই টাইপ করে — হিংলিশ, টাইপো, অস্পষ্ট শব্দ, দুটি নথি লাগে এমন প্রশ্ন — আর টিউনিংয়ে কখনও ব্যবহার হয়নি: বিভিন্ন রানে ২০-এ ১৯–২০, ৯৫–৯৬% বিশ্বস্ততায়। একটি রানের ভুলটি শিক্ষণীয়: (হিংলিশে) জিজ্ঞেস করা হয়েছিল কোম্পানির ল্যাপটপ ক্যাবে ফেলে এলে কী করতে হবে, আর এটি ২৪×৭ IT Security লাইনের বদলে সাধারণ IT হেল্পডেস্ক দেখিয়েছে এবং পুলিশ রিপোর্টের ধাপ বাদ দিয়েছে — ঠিক এমন ফাঁক ধরতেই ব্লাইন্ড সেট।
দুটো কথা লুকানোর বদলে বলে রাখি: যাচাই করে একটি AI বিচারক (Claude) রেফারেন্স উত্তরের সঙ্গে মিলিয়ে, যা অ্যাসিস্ট্যান্টের একই মডেল পরিবারের, আর ফলগুলো মানুষ যাচাই করেনি; এবং আমাদের নমুনা নথি বেশিরভাগ আসল কোম্পানি ফাইলের চেয়ে পরিচ্ছন্ন। সংখ্যাগুলোকে ইঙ্গিত হিসেবে দেখুন। প্রতিটি প্রশ্ন, উত্তর আর গ্রেড কোয়ালিটি পাতায় প্রকাশ্য।
সমান গুরুত্বপূর্ণ: যে প্রশ্নের উত্তর নথিতে নেই, সেগুলো পায় একটি সৎ “আমি নথিতে এটি খুঁজে পাইনি” — কোনো বানানো কথা নয়।
এই শৃঙ্খলাই আমরা ক্লায়েন্ট প্রজেক্টে আনি: প্রথম দিন থেকে আসল প্রশ্নের একটি টেস্ট সেট, প্রম্পট, মডেল বা নথি বদলালেই আবার চালানো হয়, যাতে কোয়ালিটি হয় এমন একটি সংখ্যা যা ট্র্যাক করা যায় — কোনো অনুভূতি নয়।
আপনার ডেটায় চালানো
ডেমোটি চলে সেই স্ট্যাকে যা আমরা ক্লায়েন্টদের জন্য বসাই: Next.js, pgvector-সহ PostgreSQL আর Claude, আপনার পছন্দের ইনফ্রাস্ট্রাকচারে — সংবেদনশীল নথির জন্য আপনার নিজস্ব সার্ভারসহ। সাধারণত কাজ শুরু হয় একটি বেশি-ব্যবহৃত ওয়ার্কফ্লো (HR প্রশ্ন, প্রোডাক্ট সাপোর্ট বা অভ্যন্তরীণ SOP), পঞ্চাশটি আসল প্রশ্ন আর কয়েক সপ্তাহের মাপা পাইলট দিয়ে, মাসের পর মাস নয়। বাড়ার সঙ্গে সঙ্গে কানেক্টর (Google Drive, SharePoint, Notion), নথি-স্তরের অনুমতি আর একটি WhatsApp চ্যানেল যোগ করুন।
- #RAG
- #Case study
- #pgvector
- #Claude
- #Evaluation
সচরাচর জিজ্ঞাস্য প্রশ্ন
01এটা কি আমাদের নিজস্ব নথিতে কাজ করে?
02উত্তর নথিতে না থাকলে কী হয়?
03এটা কি আমাদের নিজস্ব সার্ভারে চালানো যায়?
AI ও RAG অ্যাপ্লিকেশন
এমন অ্যাসিস্ট্যান্ট, যা আপনার ডেটা থেকেই উত্তর দেয় — এবং সোর্সও দেখায়।
আরও পড়ুন
 ERP ও অপারেশনস
4 মিনিটে পড়ুন
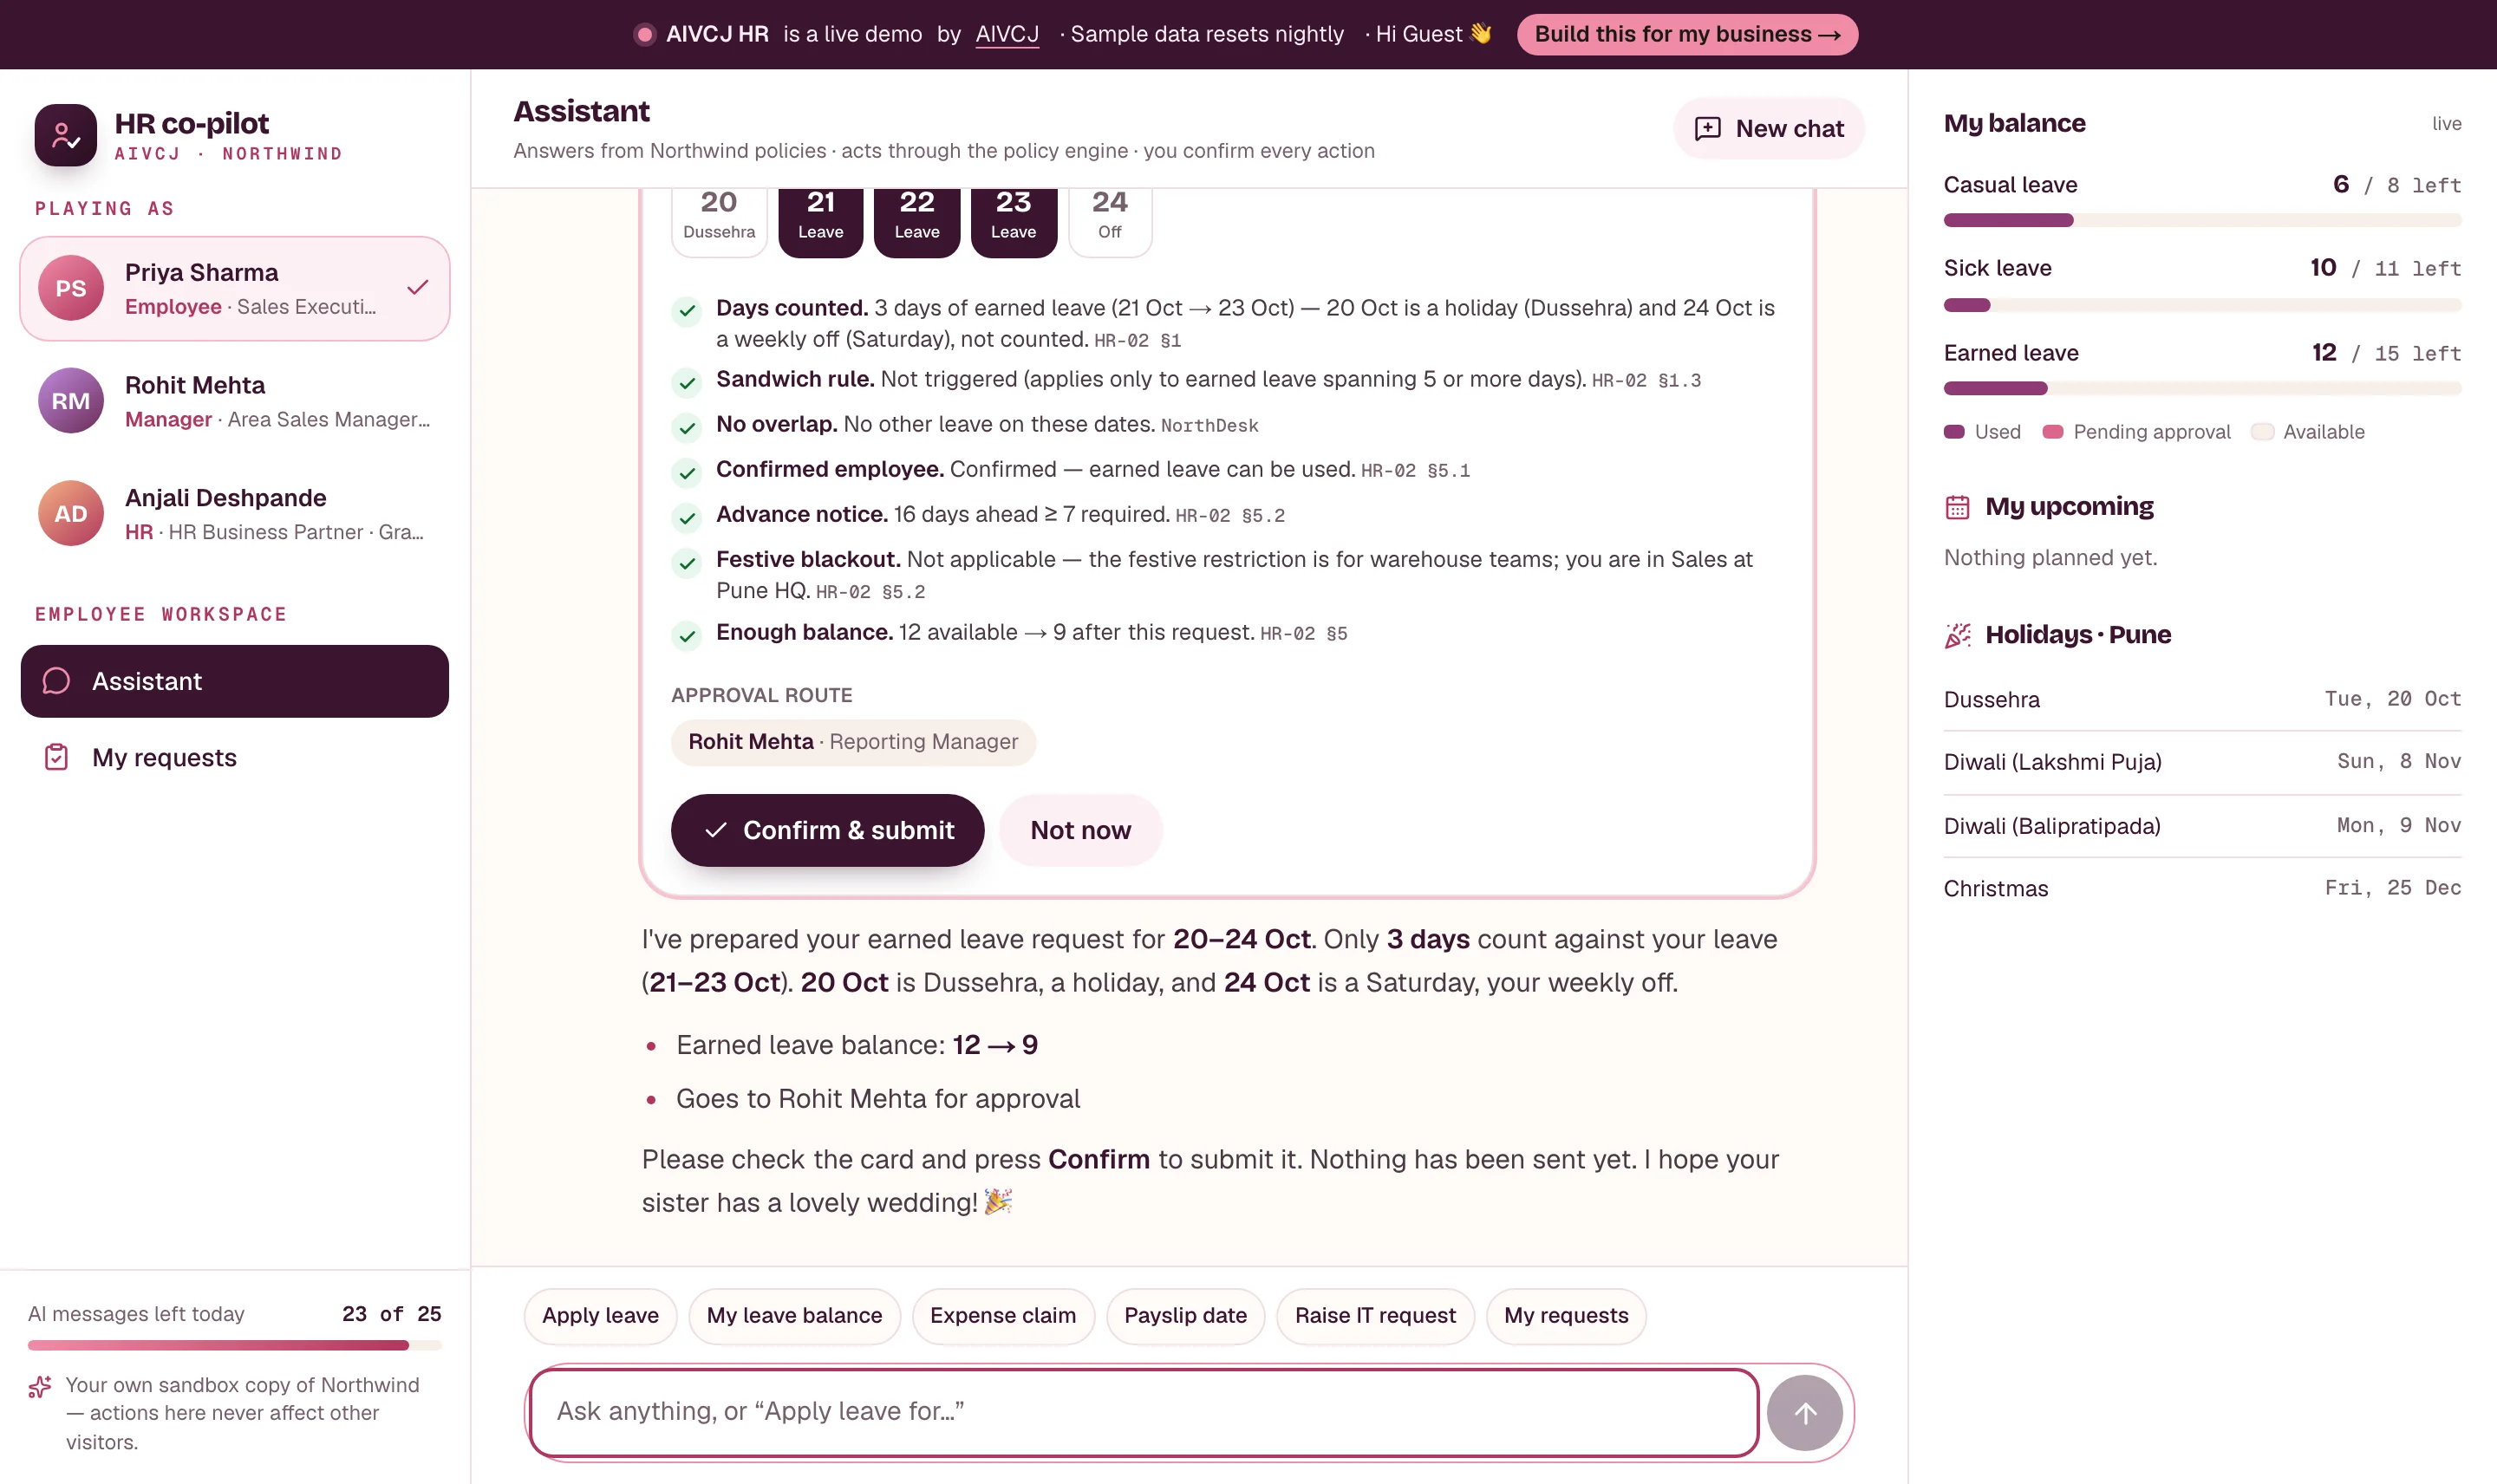
চ্যাটবট থেকে সহকর্মী: এমন একটি HR অ্যাসিস্ট্যান্ট যা নিরাপদে কাজ করে
AIVCJ HR শুধু ছুটির প্রশ্নের উত্তর দেয় না — ছুটির আবেদন করে, অনুমোদন পাঠায় এবং HR চিঠির খসড়া তৈরি করে। এখানে দেখানো হয়েছে কীভাবে আমরা AI-কে কাজ করতে দিয়েছি কিন্তু নিয়ম বানাতে দিইনি: কোডে পলিসি ইঞ্জিন, প্রতিটি কাজের আগে কনফার্মেশন কার্ড, ভূমিকা অনুযায়ী অনুমতি এবং অডিট লগ। একটি স্ক্রিপ্টেড ও একটি ব্লাইন্ড টেস্ট সেটে মাপা হয়েছে।
আরও পড়ুন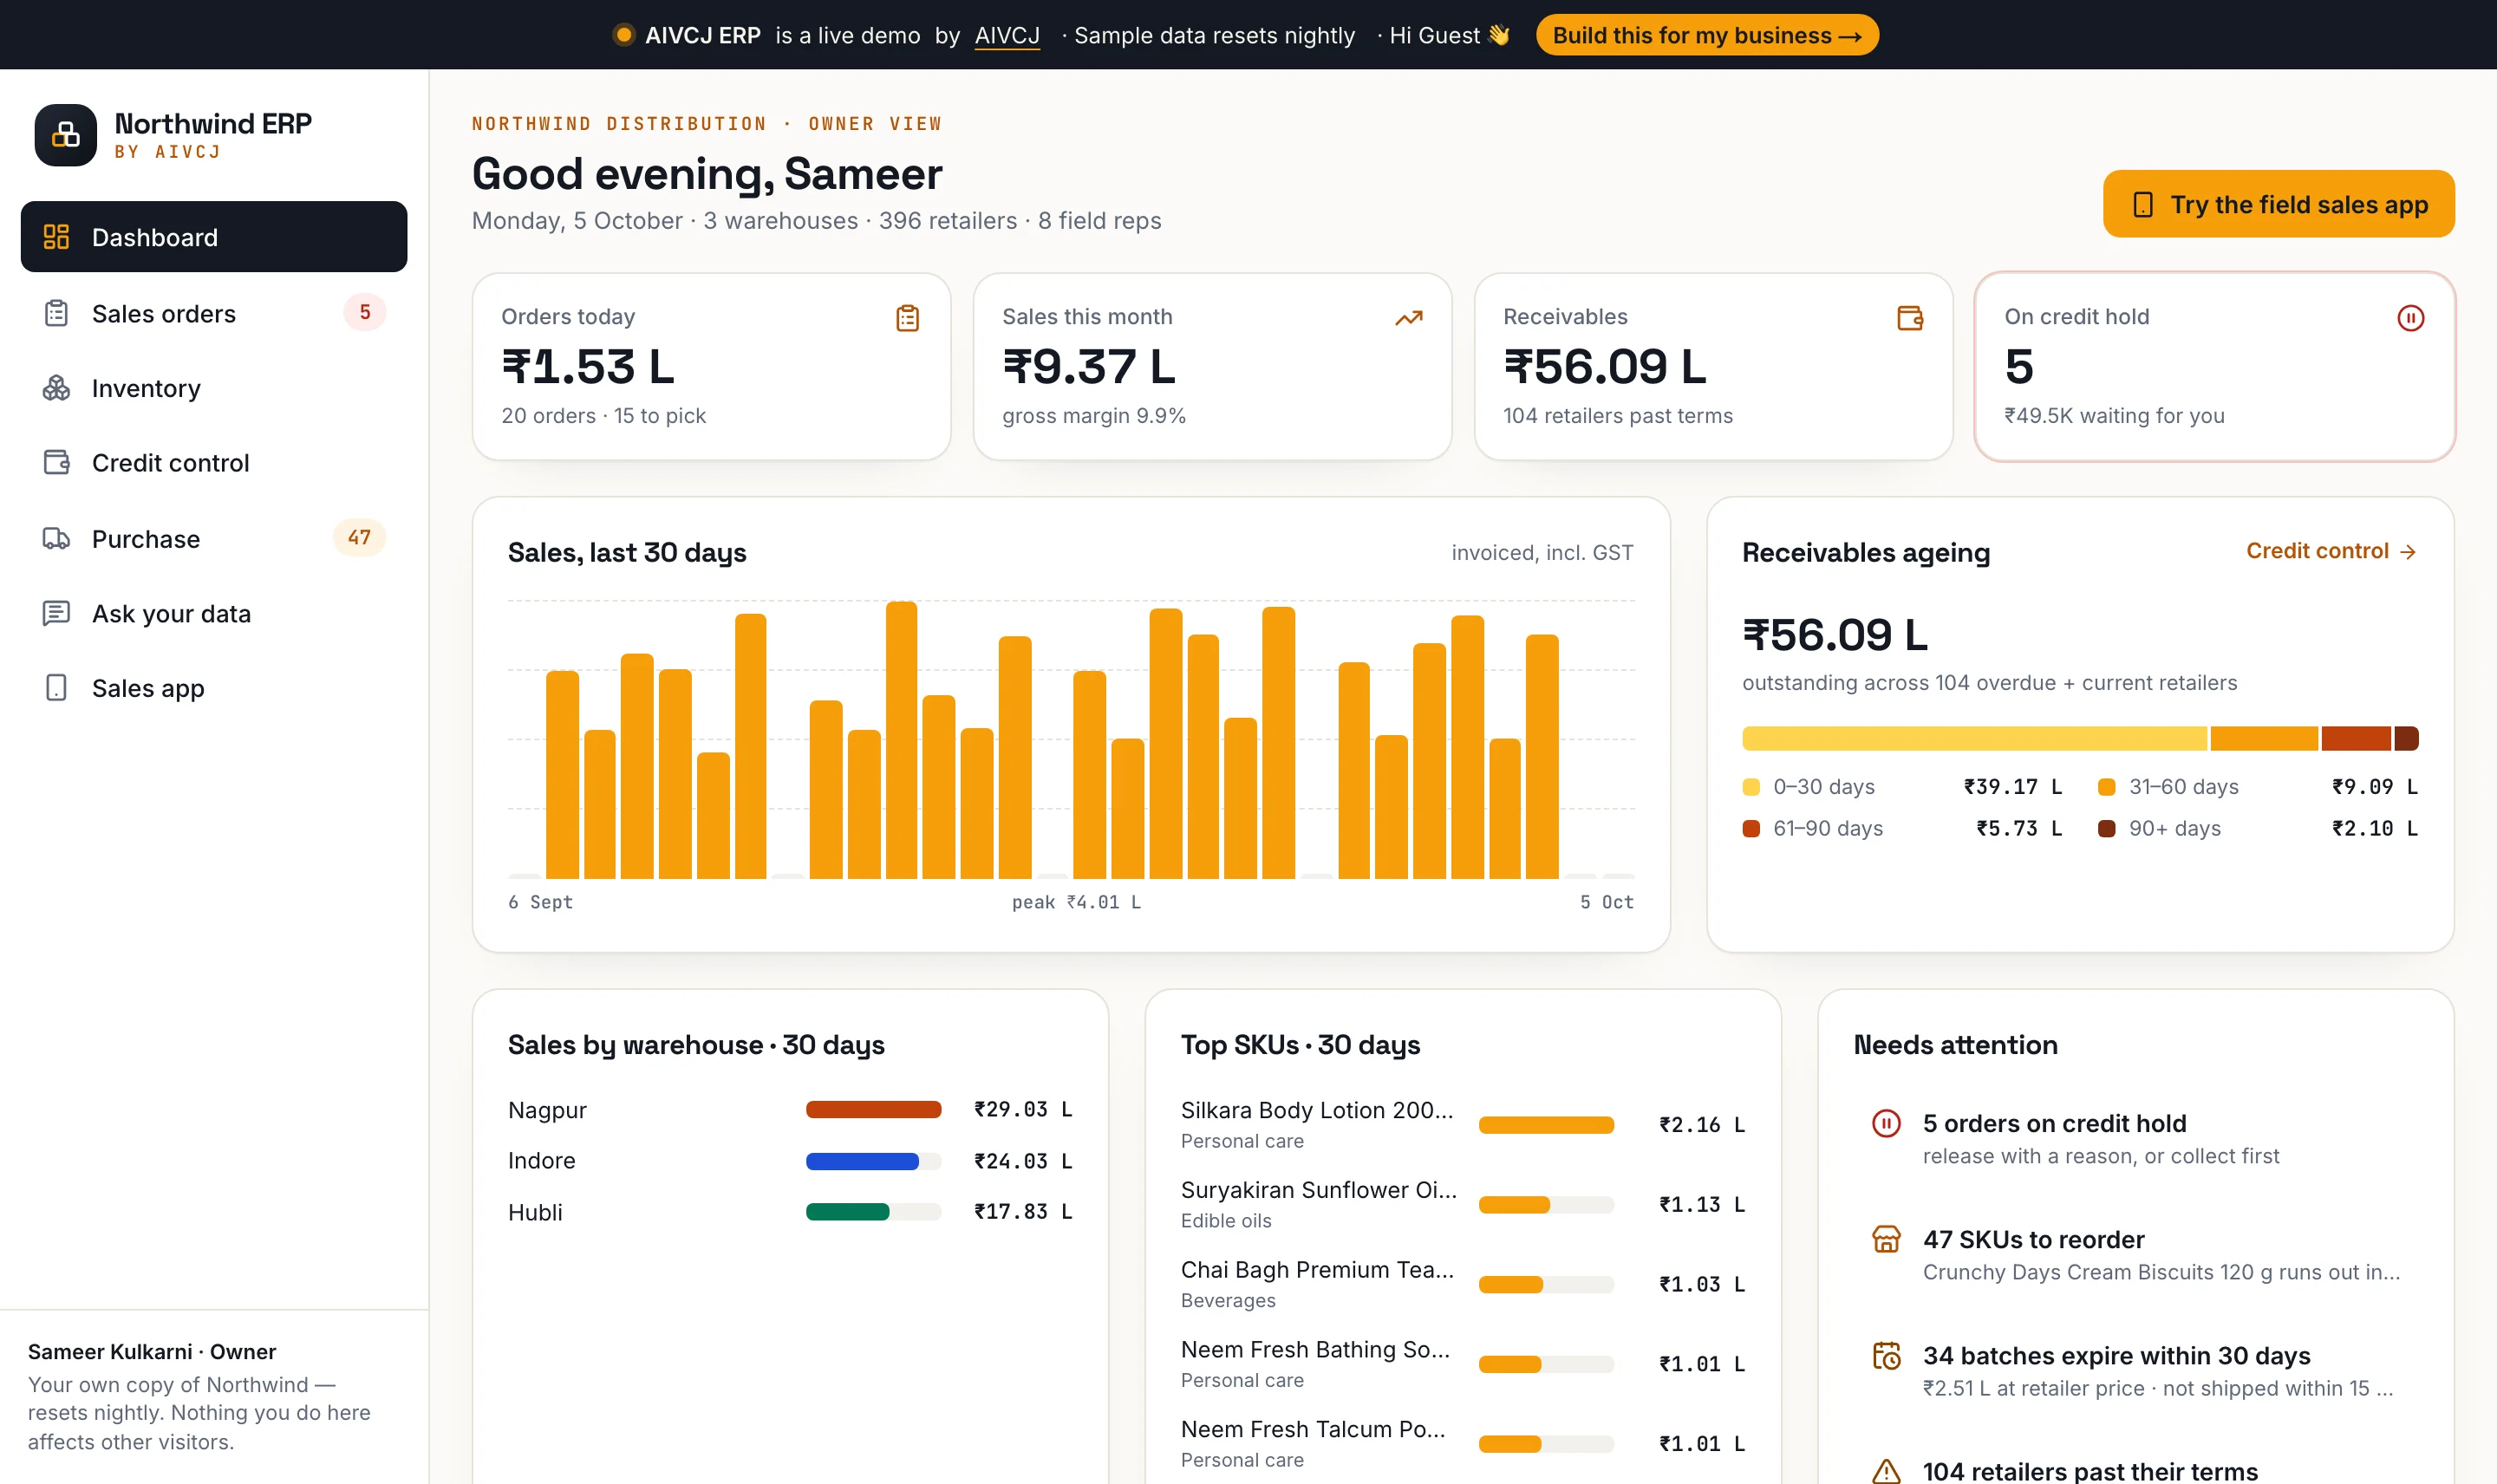 ERP ও অপারেশনস
5 মিনিটে পড়ুন
WhatsApp-এর ছবি থেকে লাইভ অর্ডার বুক: ডিস্ট্রিবিউটরদের জন্য ERP আর অফলাইন ফিল্ড অ্যাপ
AIVCJ ERP, Tally + Excel + WhatsApp-এর ঘূর্ণির জায়গা নেয়: এমন একটি ফিল্ড অ্যাপ যা নেটওয়ার্ক ছাড়াই অর্ডার নেয় আর কখনও দু'বার sync করে না, ক্রেডিট হোল্ডের সিদ্ধান্ত কোডে, GST ইনভয়েস সহ FEFO পিকিং, আর সহজ ইংরেজিতে করা প্রশ্নের উত্তর এমন একটি read-only query দিয়ে যা আপনি নিজে দেখতে পান। দুটি ফোনের sync টেস্ট আর একটি blind NL-to-SQL সেট দিয়ে মাপা।
আরও পড়ুন2 মিনিটে পড়ুন
RAG কী — আর আপনার ব্যবসার সত্যিই কখন এটা দরকার?
রিট্রিভাল-অগমেন্টেড জেনারেশন AI-কে আন্দাজ না করে আপনার নিজের ডকুমেন্ট থেকে উত্তর দিতে সাহায্য করে। জানুন এটি কীভাবে কাজ করে, কোথায় সবচেয়ে কার্যকর, আর কোন লক্ষণে বুঝবেন আপনি তৈরি।
আরও পড়ুন