Por qué la mayoría de los chatbots de empresa se inventan respuestas — y cómo construimos uno que cita sus fuentes
Entre bastidores de AIVCJ Knowledge: recuperación híbrida, planificación de consultas, una comprobación de fundamento en cada respuesta y dos conjuntos de pruebas públicos, incluido uno ciego escrito como escribe la gente de verdad. Pruébalo en vivo con documentos de ejemplo de RR. HH., producto y GST, o con tu propio PDF.
Todas las empresas tienen el mismo problema. Las respuestas existen —en una política de permisos, un PDF de garantía, un procedimiento de 2023—, pero nadie las encuentra, así que la gente pregunta a un compañero, adivina o abre una incidencia. Un chatbot parece la solución obvia. La mayoría decepciona por una razón: responden con seguridad incluso cuando no saben, y nadie puede comprobar de dónde salió la respuesta.
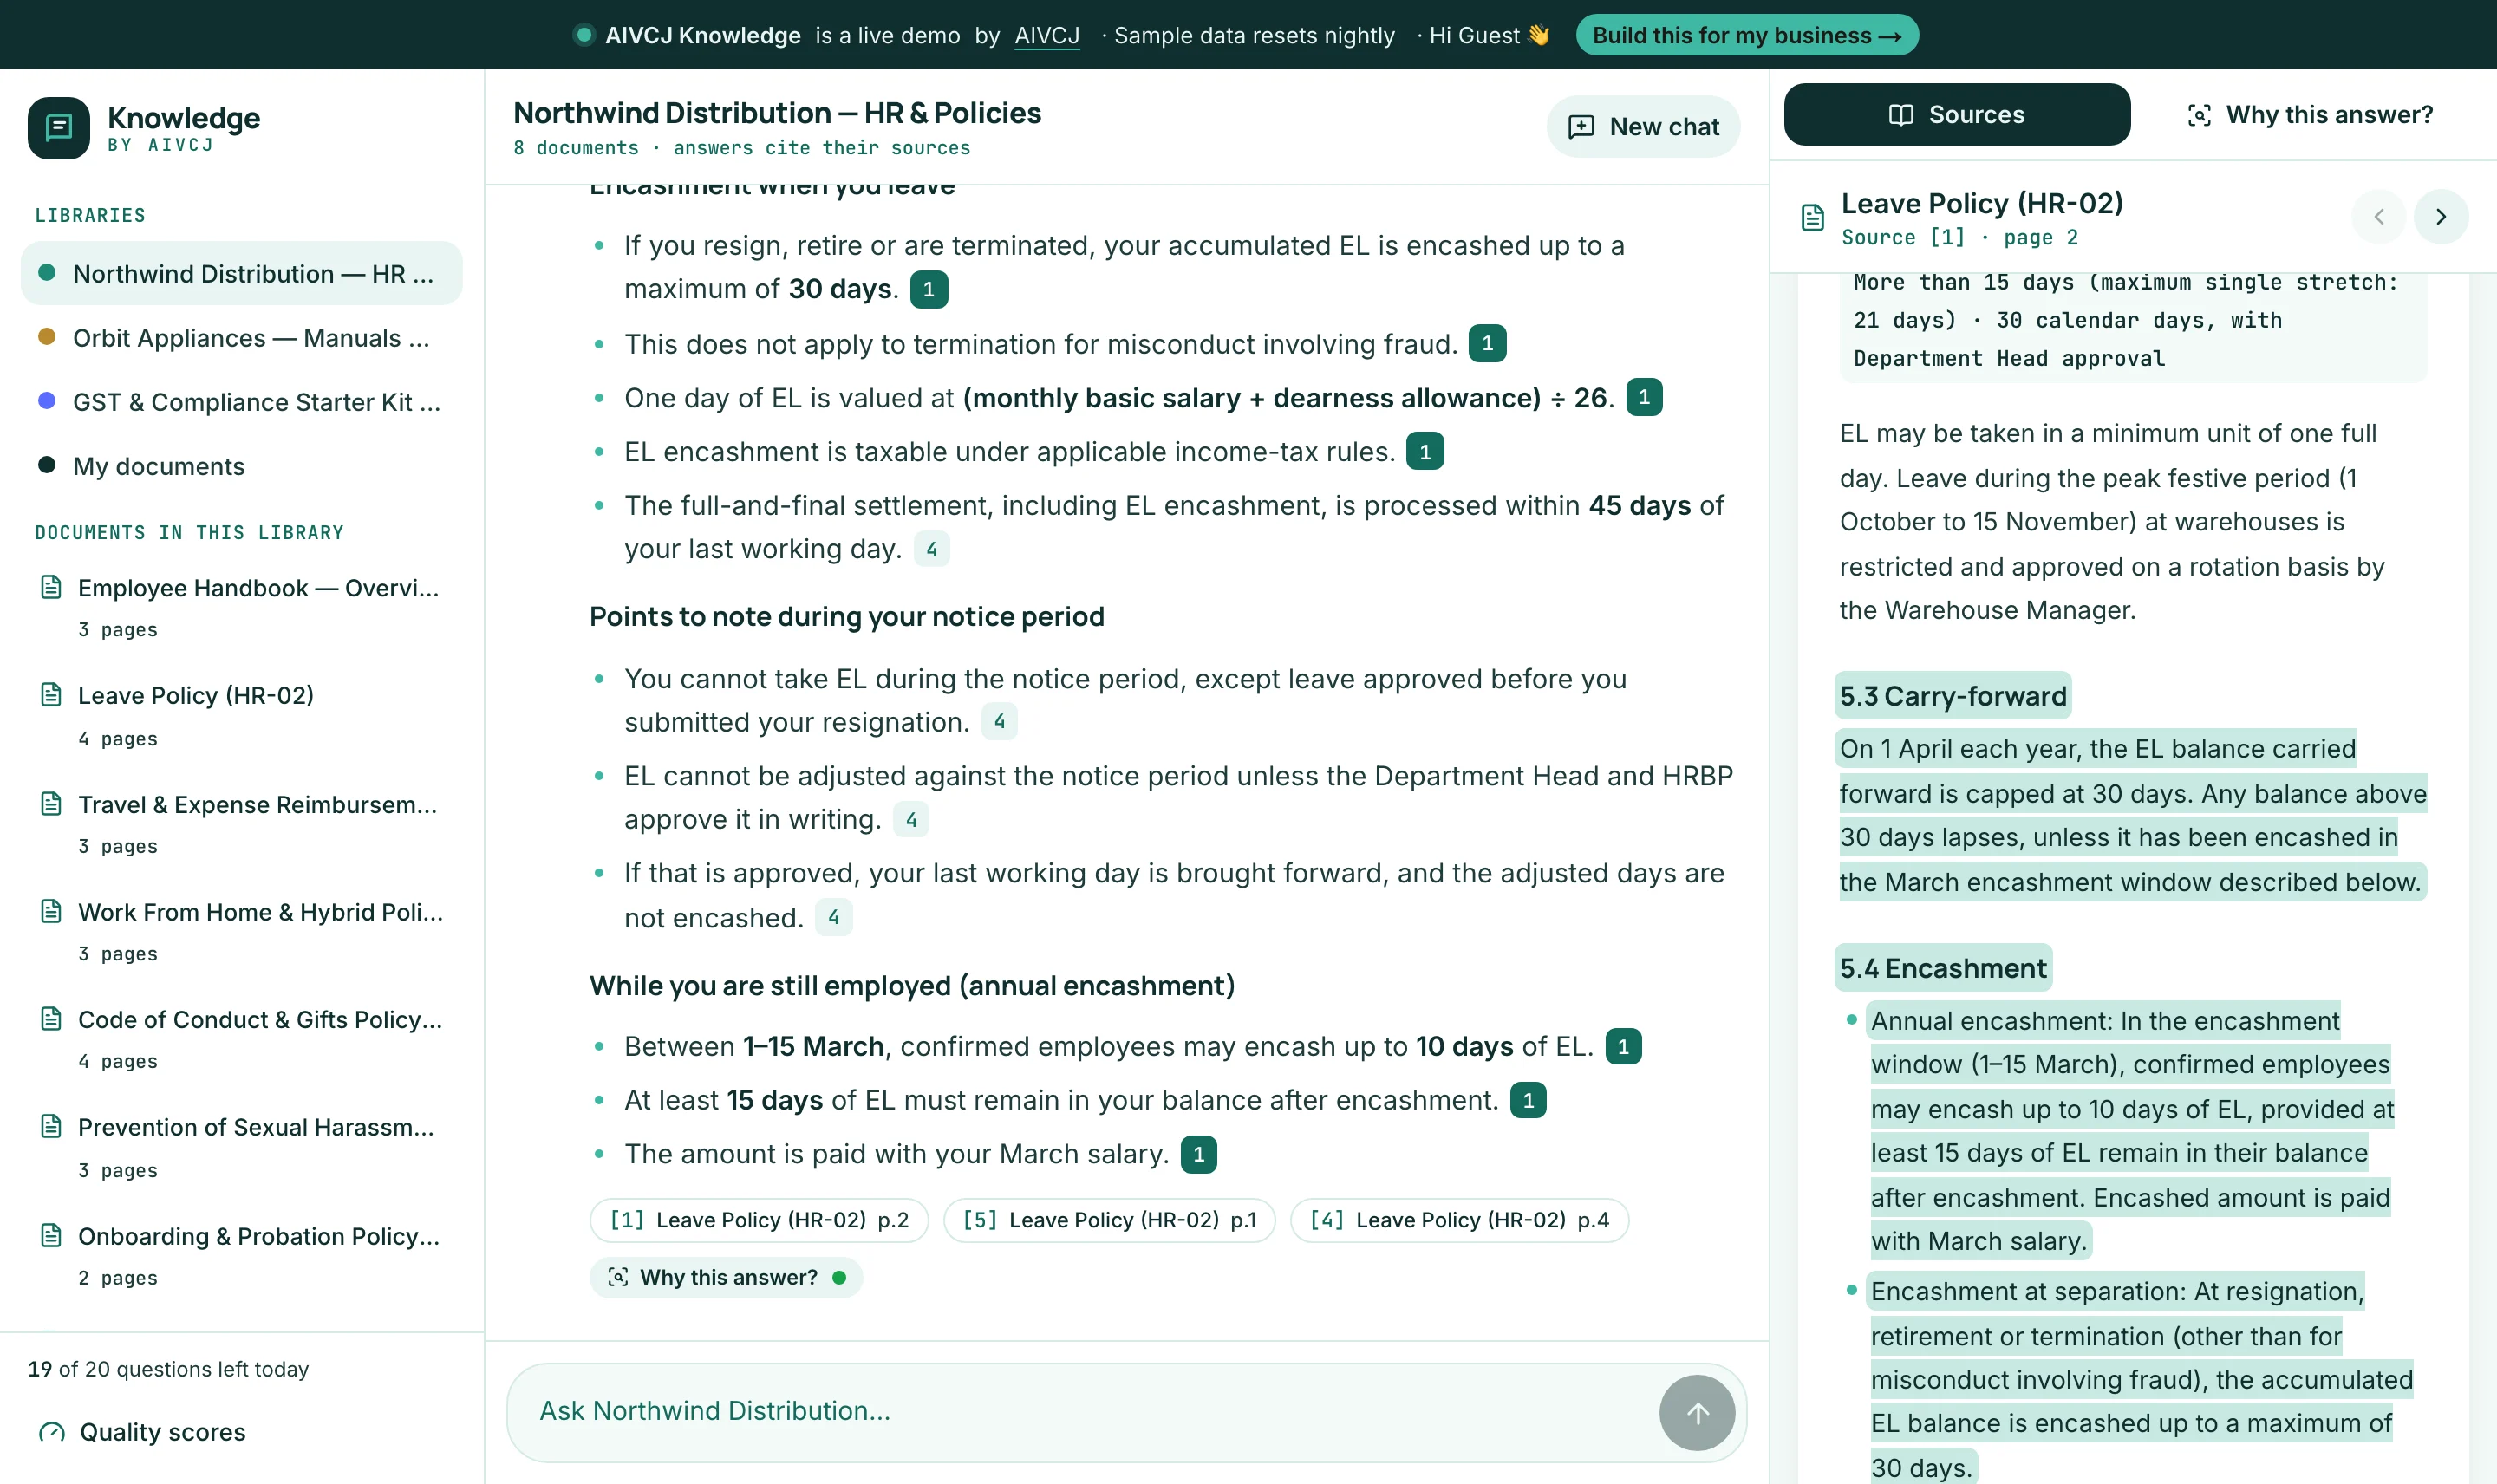
Construimos AIVCJ Knowledge para mostrar cómo es la alternativa. Es una demo en vivo que puedes abrir hoy: elige una biblioteca de ejemplo, haz una pregunta real y cada frase de la respuesta apunta al pasaje exacto del que salió.
El problema: hablar con fluidez no es lo mismo que acertar
Un modelo de lenguaje por sí solo responde de memoria. Pregúntale por tu regla de traspaso de vacaciones y producirá algo verosímil a partir de las políticas de miles de otras empresas. La recuperación simple (RAG) ayuda, pero las versiones ingenuas fallan de formas previsibles:
- Preguntas con varias partes. «Entré hace dos meses en Finanzas, ¿puedo teletrabajar dos días a la semana?» necesita la política híbrida y la regla del periodo de prueba. Una sola búsqueda rara vez encuentra ambas.
- Tablas y títulos se separan. Corta un documento cada 900 caracteres y la tabla de dietas acaba separada del título que dice de qué trata.
- Ningún «no lo sé» honesto. Cuando no se recupera el pasaje correcto, el modelo rellena el hueco.
- Ninguna forma de comprobarlo. Sin citas, una respuesta equivocada parece exactamente igual que una correcta.
Cómo funciona AIVCJ Knowledge
- Ingesta que respeta la estructura. Los documentos (PDF, DOCX, TXT) se dividen siguiendo su propia estructura: los títulos se quedan con su contenido, las tablas se mantienen enteras y cada pasaje recuerda su documento y sección. Ese contexto se incrusta junto con el pasaje, así que una fila de una tabla todavía «sabe» que pertenece a la sección de dietas de la política de viajes.
- Planificación de consultas. Un modelo pequeño y rápido divide cada pregunta en los hechos que necesita —la categoría del empleado, el nivel de la ciudad, la tabla de dietas— y cada uno se convierte en su propia búsqueda.
- Recuperación híbrida. Cada búsqueda se ejecuta de dos formas dentro de PostgreSQL: por significado (embeddings de pgvector) y por palabras exactas (búsqueda de texto completo). Los resultados se combinan con reciprocal-rank fusion, y cada parte de la pregunta tiene un hueco garantizado.
- Respuesta solo desde las fuentes. Claude escribe la respuesta únicamente a partir de los pasajes recuperados, citando cada afirmación como [1], [2]… Si los documentos no lo cubren, lo dice claramente.
- Comprobación de fundamento. Una segunda pasada compara la respuesta terminada con sus fuentes y la etiqueta como totalmente respaldada, parcialmente respaldada o no está en los documentos, visible para el usuario.
Qué ves en la demo
- Citas clicables que abren la página de origen con el pasaje exacto resaltado.
- «¿Por qué esta respuesta?»: cada pasaje recuperado con sus puntuaciones de significado, palabra clave y fusión, cuáles se citaron, el veredicto de fundamento, el tiempo empleado y los tokens usados.
- Tu propio documento. Sube un PDF o un Word (privado para ti, se borra cada noche) y haz preguntas sobre él en segundos.
- Una página de calidad con los resultados completos de las pruebas, pregunta por pregunta.
Medido, no supuesto — y honesto sobre los límites
Cada biblioteca de ejemplo tiene dos conjuntos de pruebas, y cada respuesta se comprueba en fidelidad a las fuentes y relevancia para la pregunta.
- Conjunto dorado (45 preguntas). Escrito junto con los documentos, incluidas preguntas que necesitan varios documentos y preguntas que los documentos deliberadamente no responden. Lo usamos al ajustar el sistema, así que nos favorece. Nuestra primera versión —fragmentos de tamaño fijo y una sola búsqueda por pregunta— sacó 40 de 45 con un 91–93 % de fidelidad; todos los fallos eran preguntas de varias partes. La fragmentación que respeta la estructura, los embeddings con contexto y la planificación de consultas lo subieron a 42–45 de 45 según la ejecución, con un 98–100 % de fidelidad.
- Conjunto ciego (20 preguntas). Escrito después por otra persona tal como escribe la gente de verdad —hinglish, erratas, frases vagas, preguntas que necesitan dos documentos— y nunca usado para ajustar: 19–20 de 20 según la ejecución, con un 95–96 % de fidelidad. El fallo de una ejecución es instructivo: al preguntar (en hinglish) qué hacer tras dejarse un portátil de empresa en un taxi, dio el servicio de ayuda de TI habitual en lugar de la línea de Seguridad TI 24×7 y se saltó el paso de la denuncia a la policía — justo el tipo de hueco que un conjunto ciego existe para detectar.
Dos advertencias que preferimos decir antes que ocultar: la evaluación la hace un juez de IA (Claude) frente a respuestas de referencia, de la misma familia de modelos que el asistente, y los resultados no están verificados por personas; y nuestros documentos de ejemplo están más limpios que la mayoría de los archivos reales de una empresa. Toma las cifras como orientativas. Cada pregunta, respuesta y nota es pública en la página de calidad.
Igual de importante: las preguntas que los documentos no cubren reciben un honesto «No he encontrado esto en los documentos», no una invención.
Esta es la disciplina que llevamos a los proyectos de clientes: un conjunto de preguntas reales desde el primer día, que se vuelve a ejecutar cada vez que cambia un prompt, un modelo o un documento, para que la calidad sea un número que puedas seguir y no una sensación.
Ponerlo en marcha con tus datos
La demo funciona con el mismo stack que implantamos para clientes: Next.js, PostgreSQL con pgvector y Claude, en la infraestructura que elijas, incluidos tus propios servidores para documentos sensibles. Un proyecto típico empieza con un flujo de mucho volumen (preguntas de RR. HH., soporte de producto o procedimientos internos), cincuenta preguntas reales y un piloto medido en semanas, no en meses. Añade conectores (Google Drive, SharePoint, Notion), permisos por documento y un canal de WhatsApp a medida que creces.
- #RAG
- #Case study
- #pgvector
- #Claude
- #Evaluation
Preguntas frecuentes
01¿Funciona con nuestros propios documentos?
02¿Qué pasa si la respuesta no está en los documentos?
03¿Se puede alojar en nuestros propios servidores?
Aplicaciones de IA y RAG
Asistentes que responden con tus datos y los citan.
Sigue leyendo
 ERP y operaciones
5 min de lectura
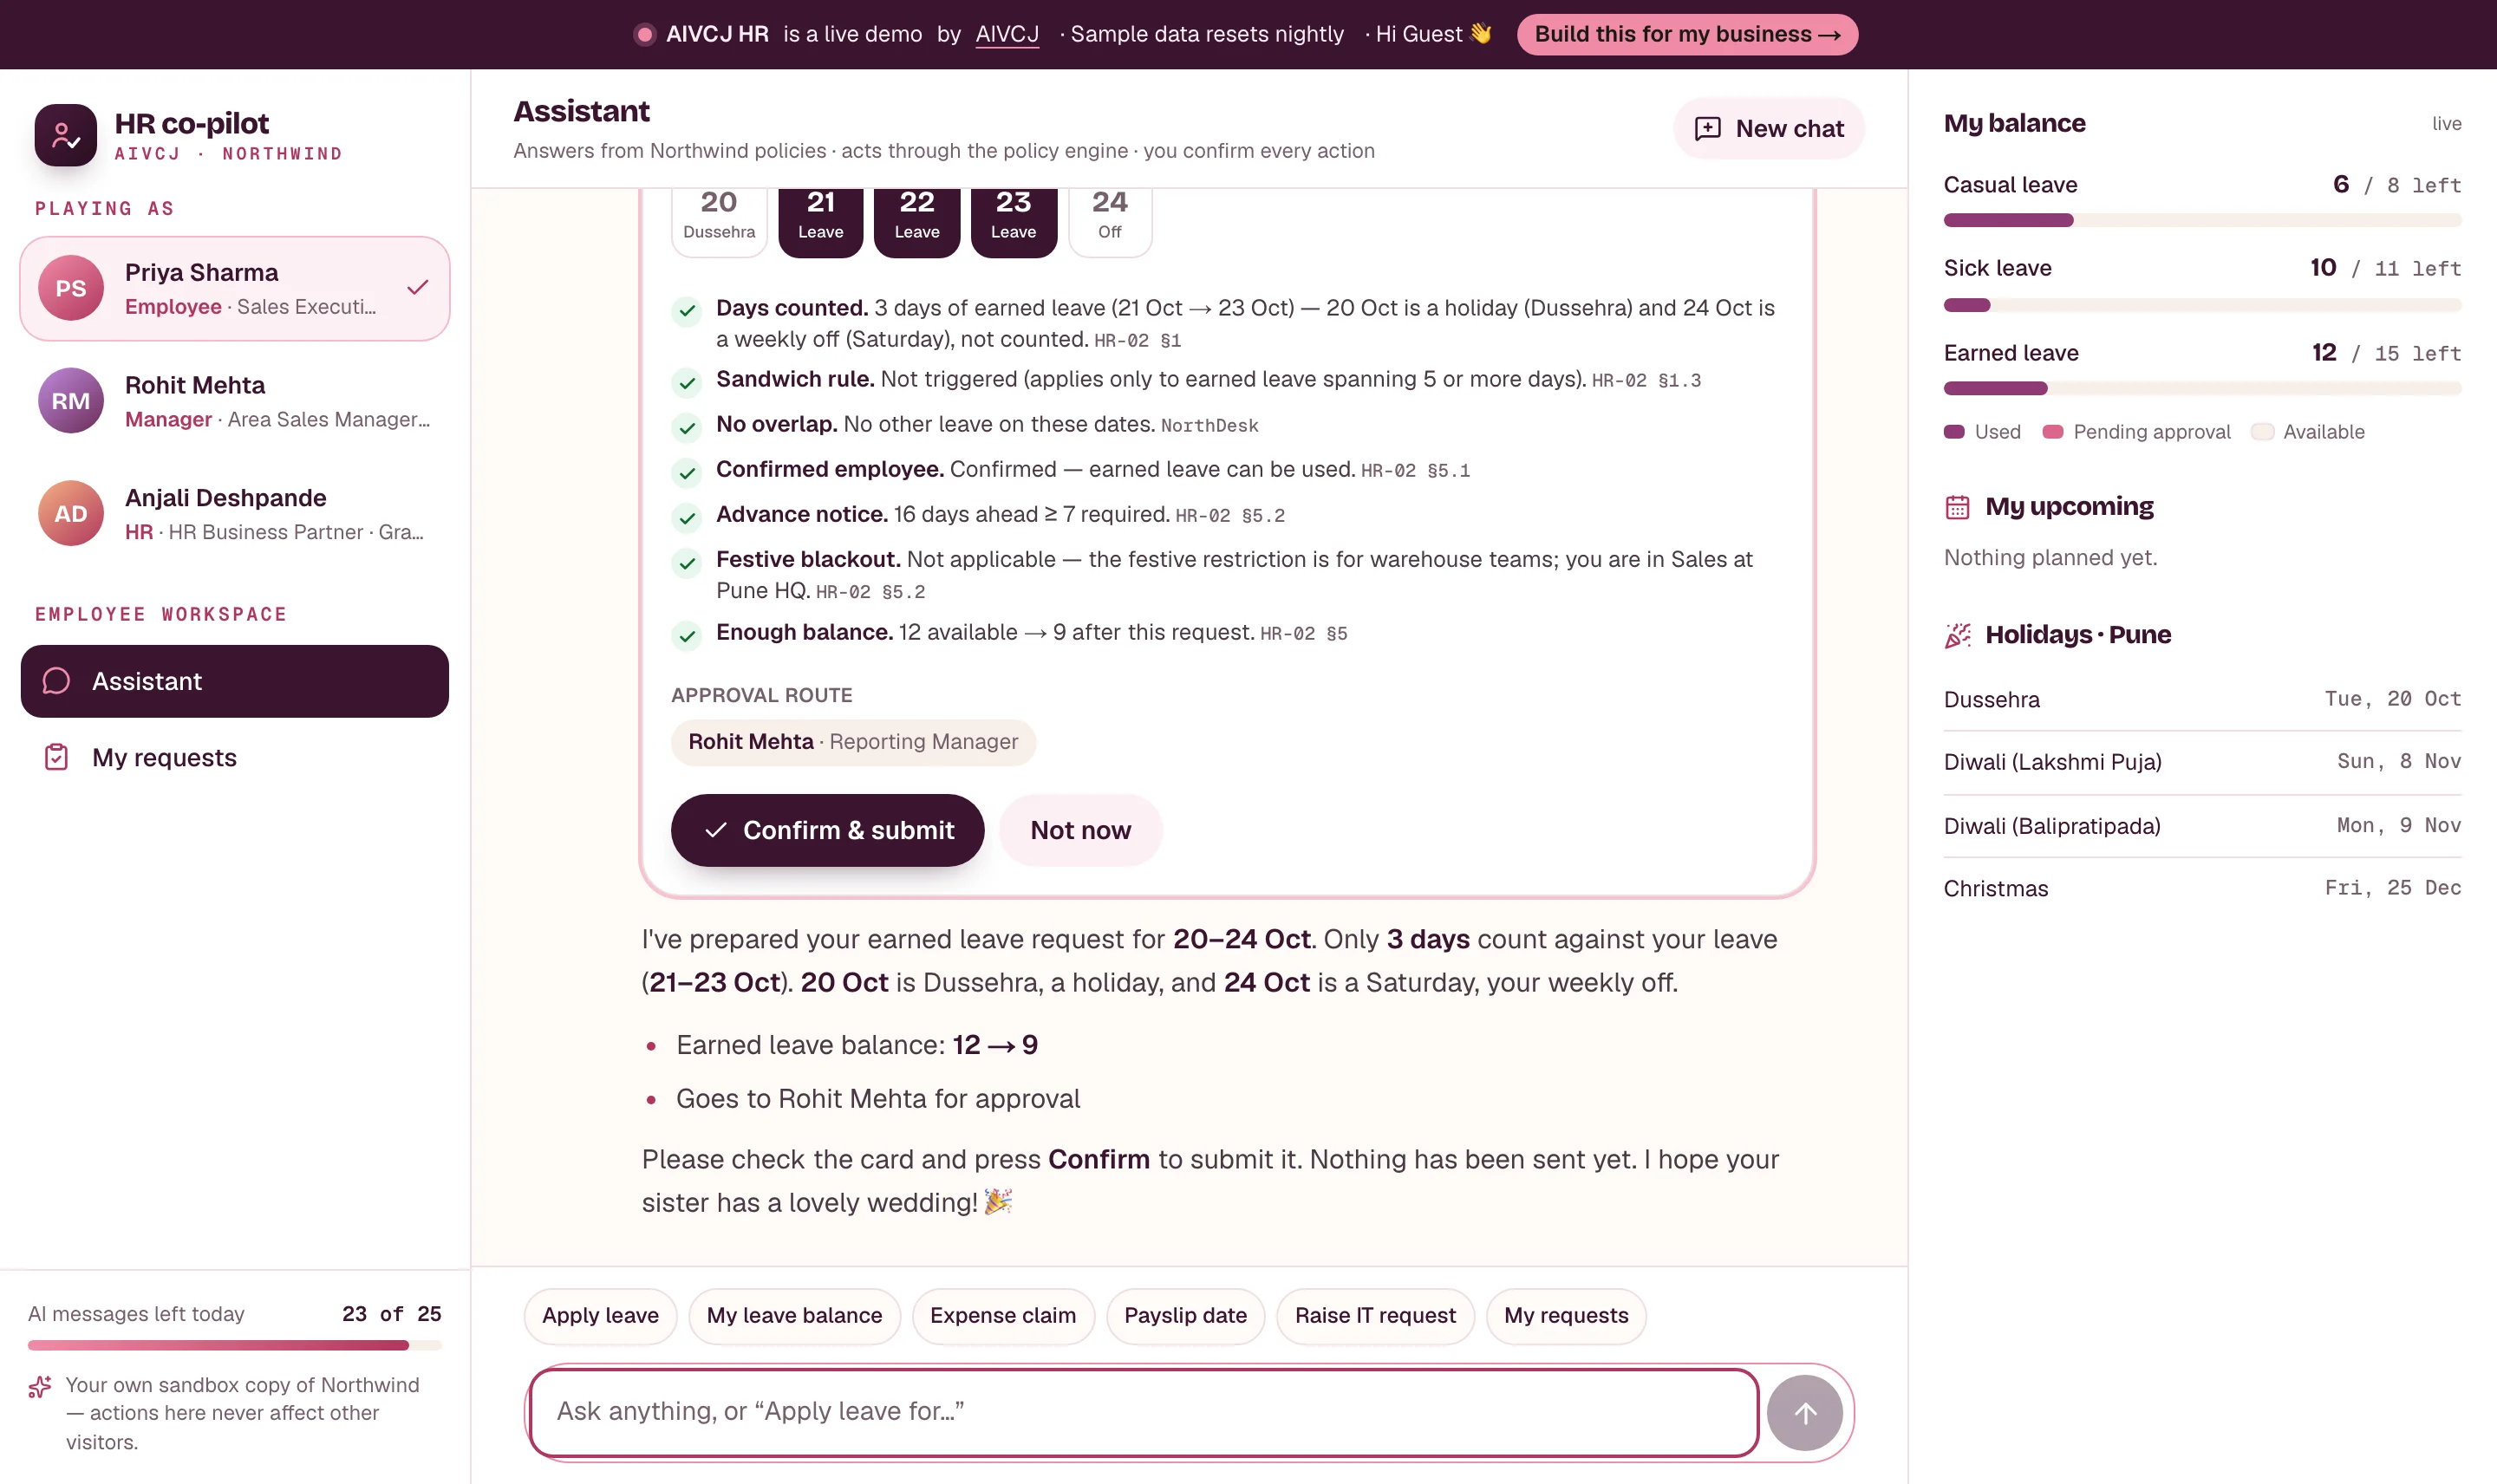
De chatbot a compañero de trabajo: un asistente de RR. HH. que actúa de forma segura
AIVCJ HR no solo responde preguntas sobre vacaciones: solicita permisos, enruta aprobaciones y redacta cartas de RR. HH. Así dejamos que una IA actúe sin dejar que ponga las reglas: un motor de políticas en código, una tarjeta de confirmación antes de cada acción, permisos por rol y un registro de auditoría. Medido con un conjunto de pruebas guionizado y otro ciego.
Leer más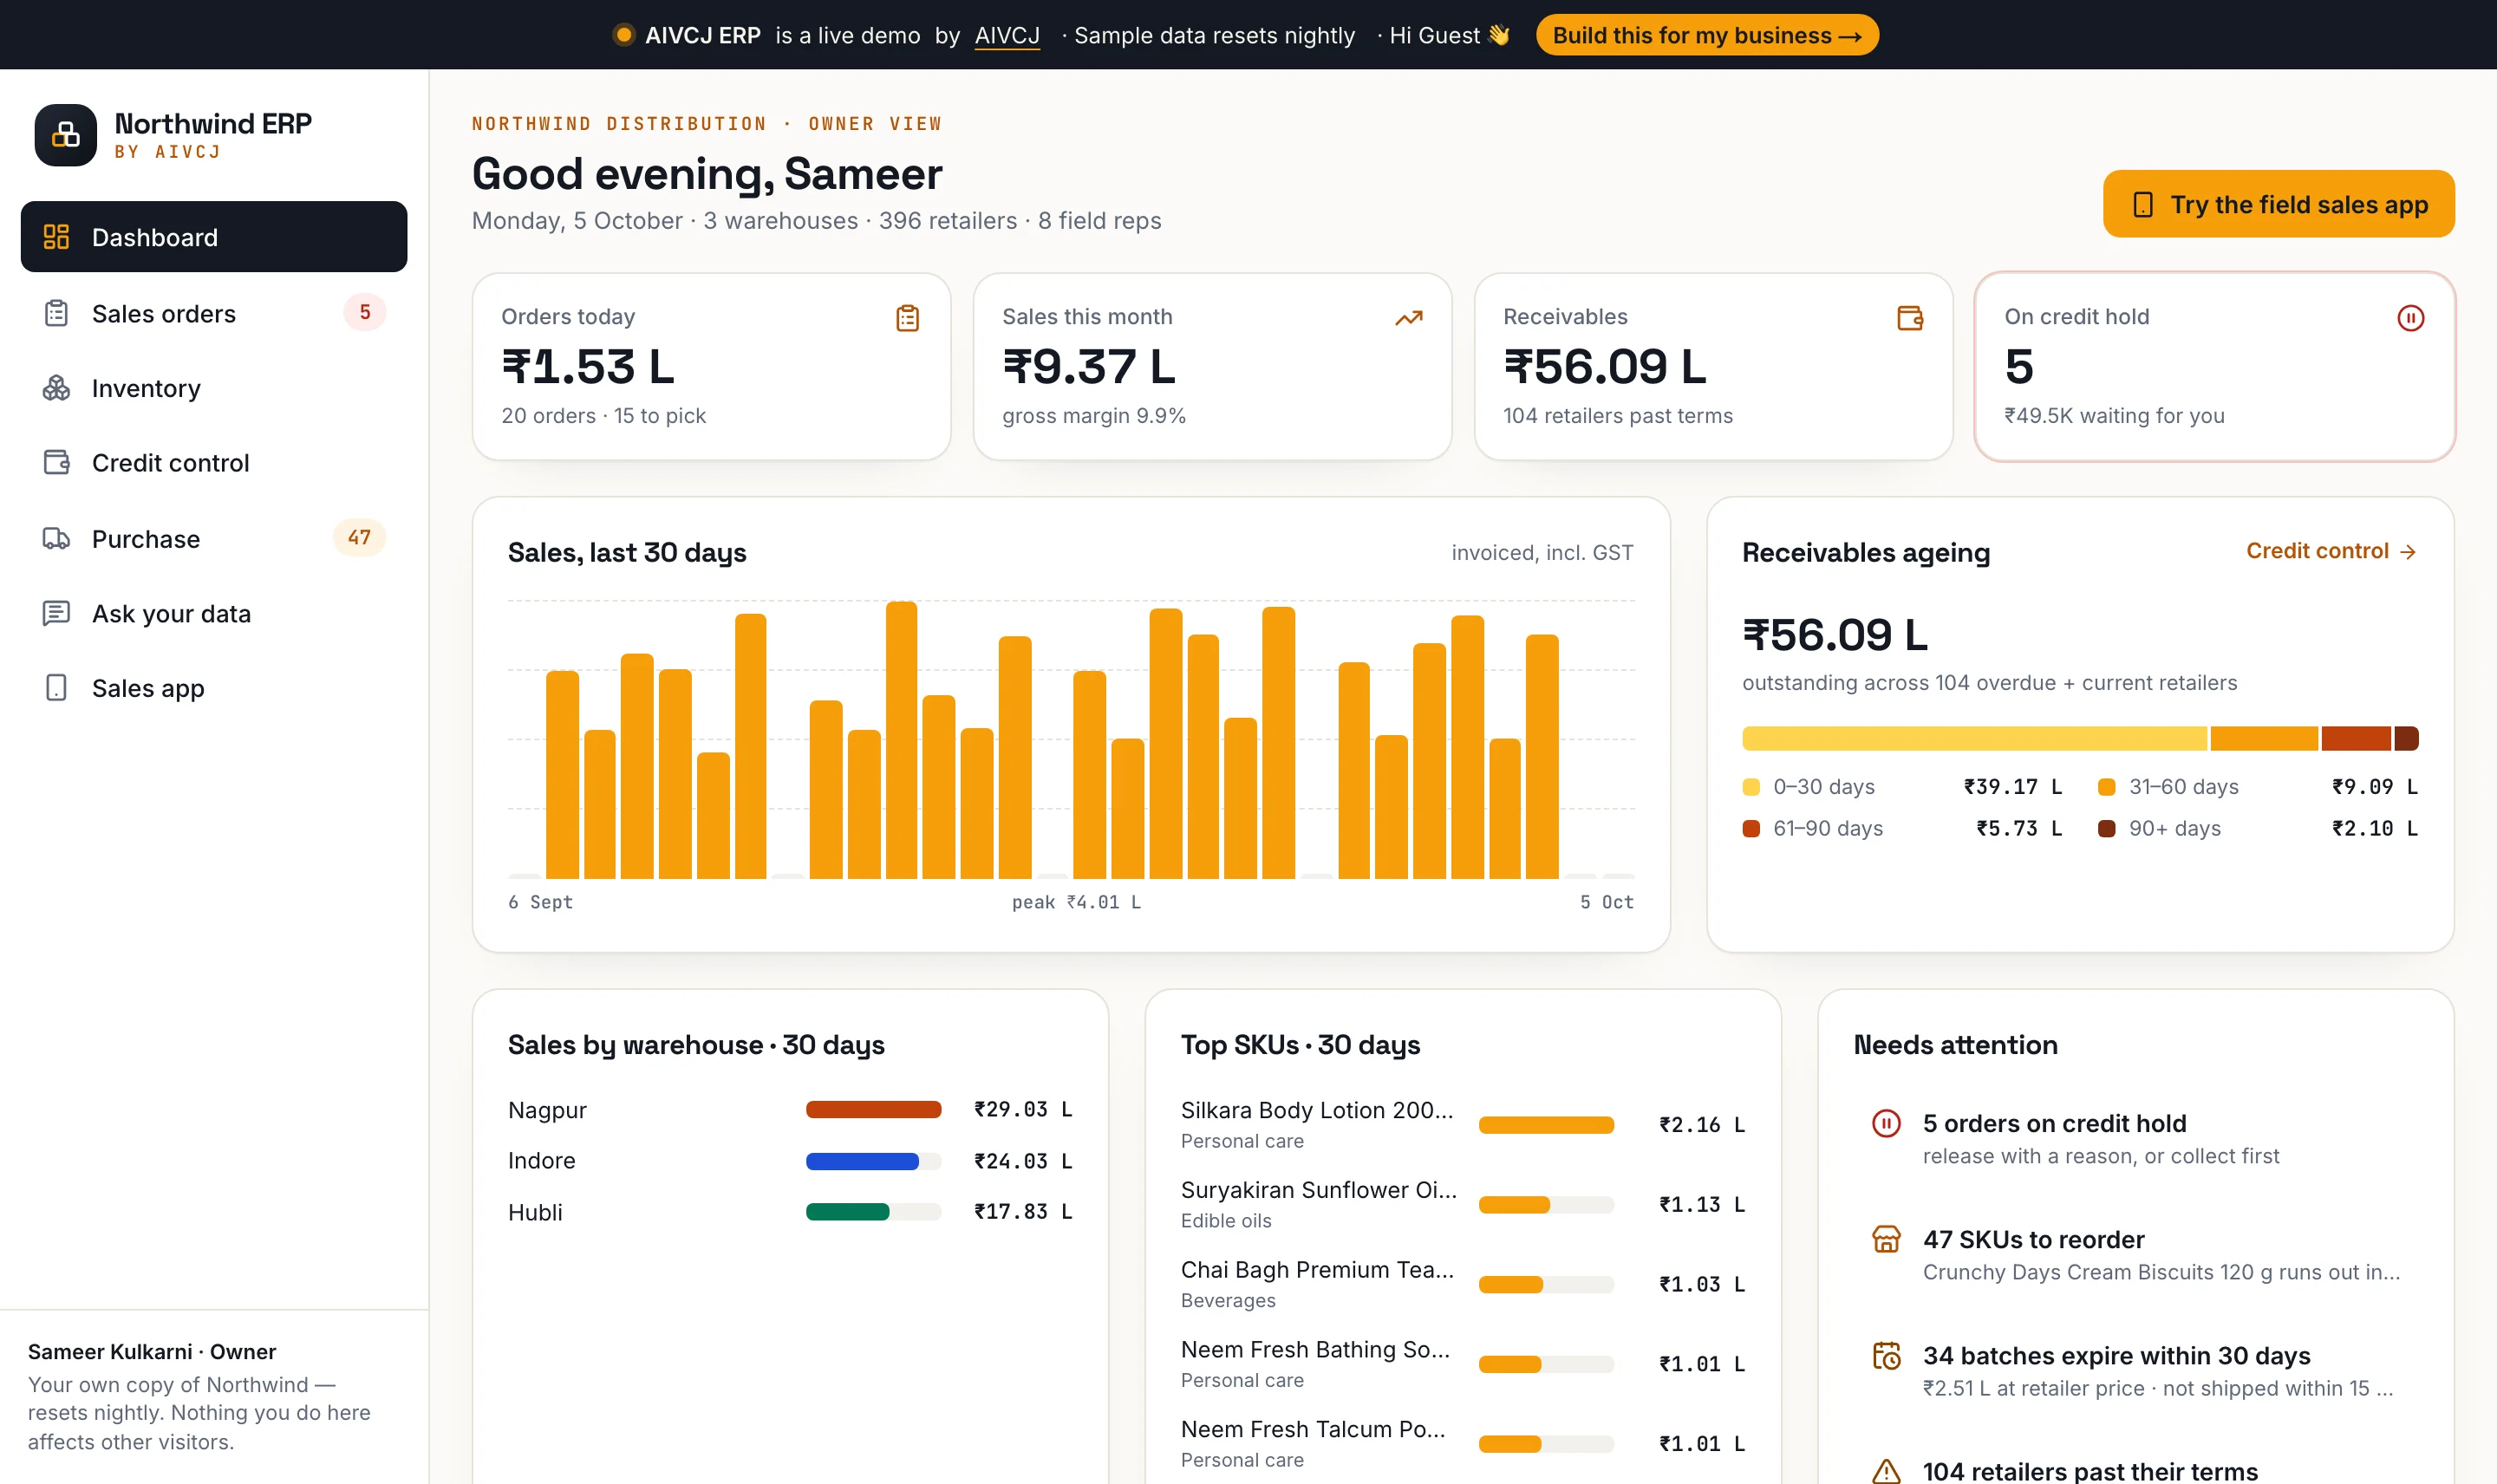 ERP y operaciones
7 min de lectura
De fotos por WhatsApp a una cartera de pedidos en vivo: un ERP y una app de campo offline para distribuidores
AIVCJ ERP sustituye el círculo Tally + Excel + WhatsApp: una app de campo que toma pedidos sin cobertura y nunca sincroniza dos veces, bloqueos por riesgo de crédito decididos en código, preparación FEFO con facturas GST y preguntas en lenguaje natural respondidas con una consulta de solo lectura que puedes ver. Medido con una prueba de sincronización con dos teléfonos y un conjunto ciego de NL a SQL.
Leer más2 min de lectura
¿Qué es RAG y cuándo lo necesita realmente tu negocio?
La generación aumentada por recuperación permite que la IA responda a partir de tus propios documentos en lugar de adivinar. Aquí explicamos cómo funciona, dónde brilla y las señales de que estás listo para ella.
Leer más