¿Qué es RAG y cuándo lo necesita realmente tu negocio?
La generación aumentada por recuperación permite que la IA responda a partir de tus propios documentos en lugar de adivinar. Aquí explicamos cómo funciona, dónde brilla y las señales de que estás listo para ella.
Los grandes modelos de lenguaje son escritores extraordinarios y pésimos bibliotecarios. Pregúntale a uno por tu política de vacaciones, las condiciones de garantía de tu producto o los precios del último trimestre y te dará una respuesta segura, fluida y, con frecuencia, equivocada. La generación aumentada por recuperación (RAG) lo soluciona dándole al modelo las páginas correctas para leer antes de responder.
Cómo funciona RAG, en términos sencillos
Un sistema RAG tiene dos mitades. La mitad de indexación lee tus documentos, los divide en pasajes y guarda una "huella de significado" numérica (un embedding) de cada pasaje en una base de datos vectorial como PostgreSQL con pgvector. La mitad de respuesta toma la pregunta del usuario, encuentra los pasajes de significado más cercano y se los entrega al modelo con una instrucción: responde solo a partir de estos y cítalos.
- Ingesta: PDF, archivos de Word, hojas de cálculo, páginas web y registros de bases de datos se limpian y se dividen en fragmentos.
- Embedding: cada fragmento se convierte en un vector que captura de qué trata.
- Recuperación: la pregunta se convierte en vector del mismo modo; se obtienen los fragmentos más cercanos, a menudo combinados con búsqueda por palabras clave.
- Generación: el modelo redacta una respuesta basada en esos fragmentos, con citas a la fuente.
¿Por qué no simplemente hacer fine-tuning de un modelo?
El fine-tuning le enseña a un modelo un estilo o una habilidad concreta. Es una mala forma de enseñarle datos que cambian: precios, políticas, inventario, contratos. RAG mantiene el conocimiento en una base de datos que tú controlas: actualiza un documento y la siguiente respuesta ya lo refleja. Además obtienes citas, control de acceso por documento y la posibilidad de cambiar de modelo sin reentrenar nada.
Cinco señales de que tu negocio está listo para RAG
- Tu equipo responde cada semana las mismas preguntas a partir de los mismos documentos.
- El conocimiento crítico vive en PDF y unidades compartidas en las que nadie busca bien.
- Los clientes esperan horas por respuestas que ya están en tus manuales.
- Las nuevas incorporaciones tardan meses en ser productivas porque "todo está en algún sitio".
- Necesitas que las respuestas respeten los permisos: no todos deben ver todo.
Qué hace que un sistema RAG esté listo para producción
Un prototipo de fin de semana puede impresionar en una demo y fallar al tercer día. La diferencia es la disciplina de ingeniería: fragmentación ajustada a tus tipos de documento, recuperación híbrida, filtros de permisos aplicados en el momento de la consulta, negarse a responder cuando faltan fuentes y, sobre todo, un conjunto de evaluación de preguntas reales con respuestas correctas conocidas, que se vuelve a ejecutar cada vez que cambia un prompt o un modelo.
Por dónde empezar
Elige un flujo de trabajo de alto volumen y bien documentado: preguntas sobre políticas de RR. HH., soporte de producto o procedimientos internos. Reúne cincuenta preguntas reales. Construye, mide y luego amplía. Así es exactamente como llevamos nuestros proyectos de RAG, y por eso nuestros asistentes siguen siendo precisos tras el lanzamiento.
- #RAG
- #pgvector
- #AI strategy
Preguntas frecuentes
01¿RAG es lo mismo que un chatbot?
Un chatbot es la interfaz; RAG es la técnica que hace que sus respuestas se basen en tus documentos y no en la memoria del modelo.
02¿Necesito una base de datos vectorial aparte?
No necesariamente. PostgreSQL con la extensión pgvector maneja millones de pasajes y mantiene tus datos en una única base de datos conocida.
Aplicaciones de IA y RAG
Asistentes que responden con tus datos y los citan.
Sigue leyendo
 ERP y operaciones
5 min de lectura
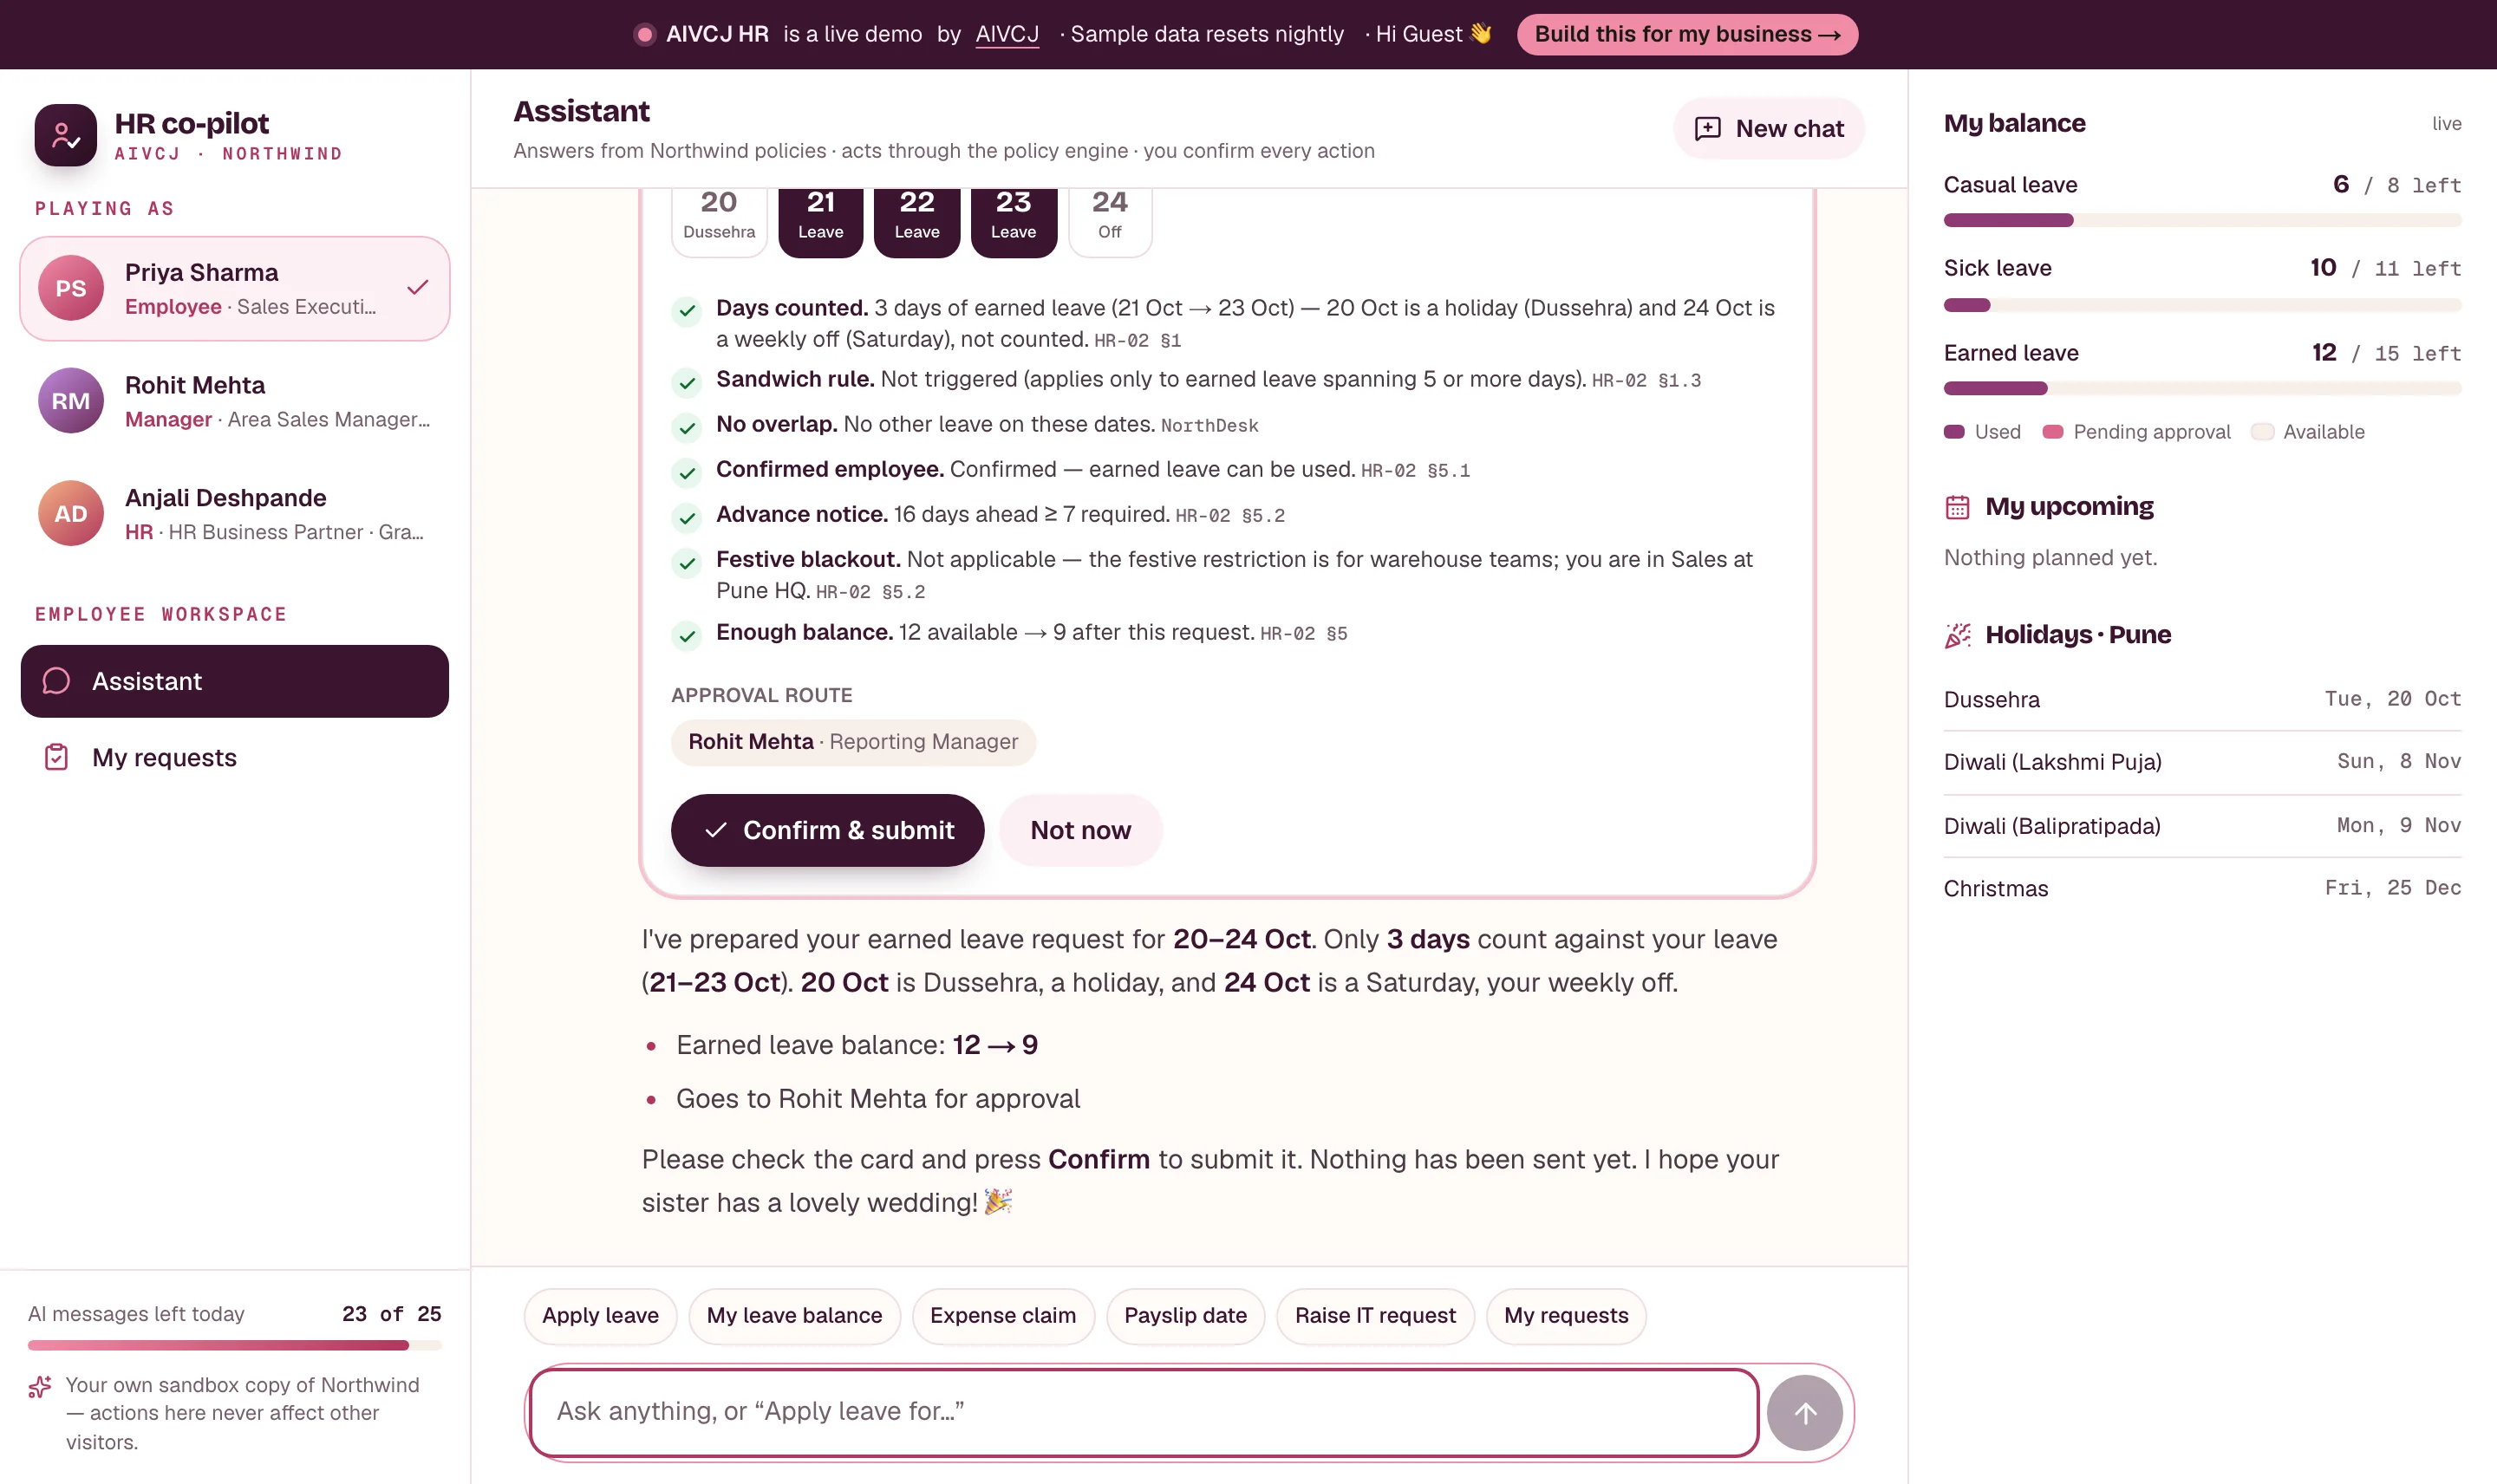
De chatbot a compañero de trabajo: un asistente de RR. HH. que actúa de forma segura
AIVCJ HR no solo responde preguntas sobre vacaciones: solicita permisos, enruta aprobaciones y redacta cartas de RR. HH. Así dejamos que una IA actúe sin dejar que ponga las reglas: un motor de políticas en código, una tarjeta de confirmación antes de cada acción, permisos por rol y un registro de auditoría. Medido con un conjunto de pruebas guionizado y otro ciego.
Leer más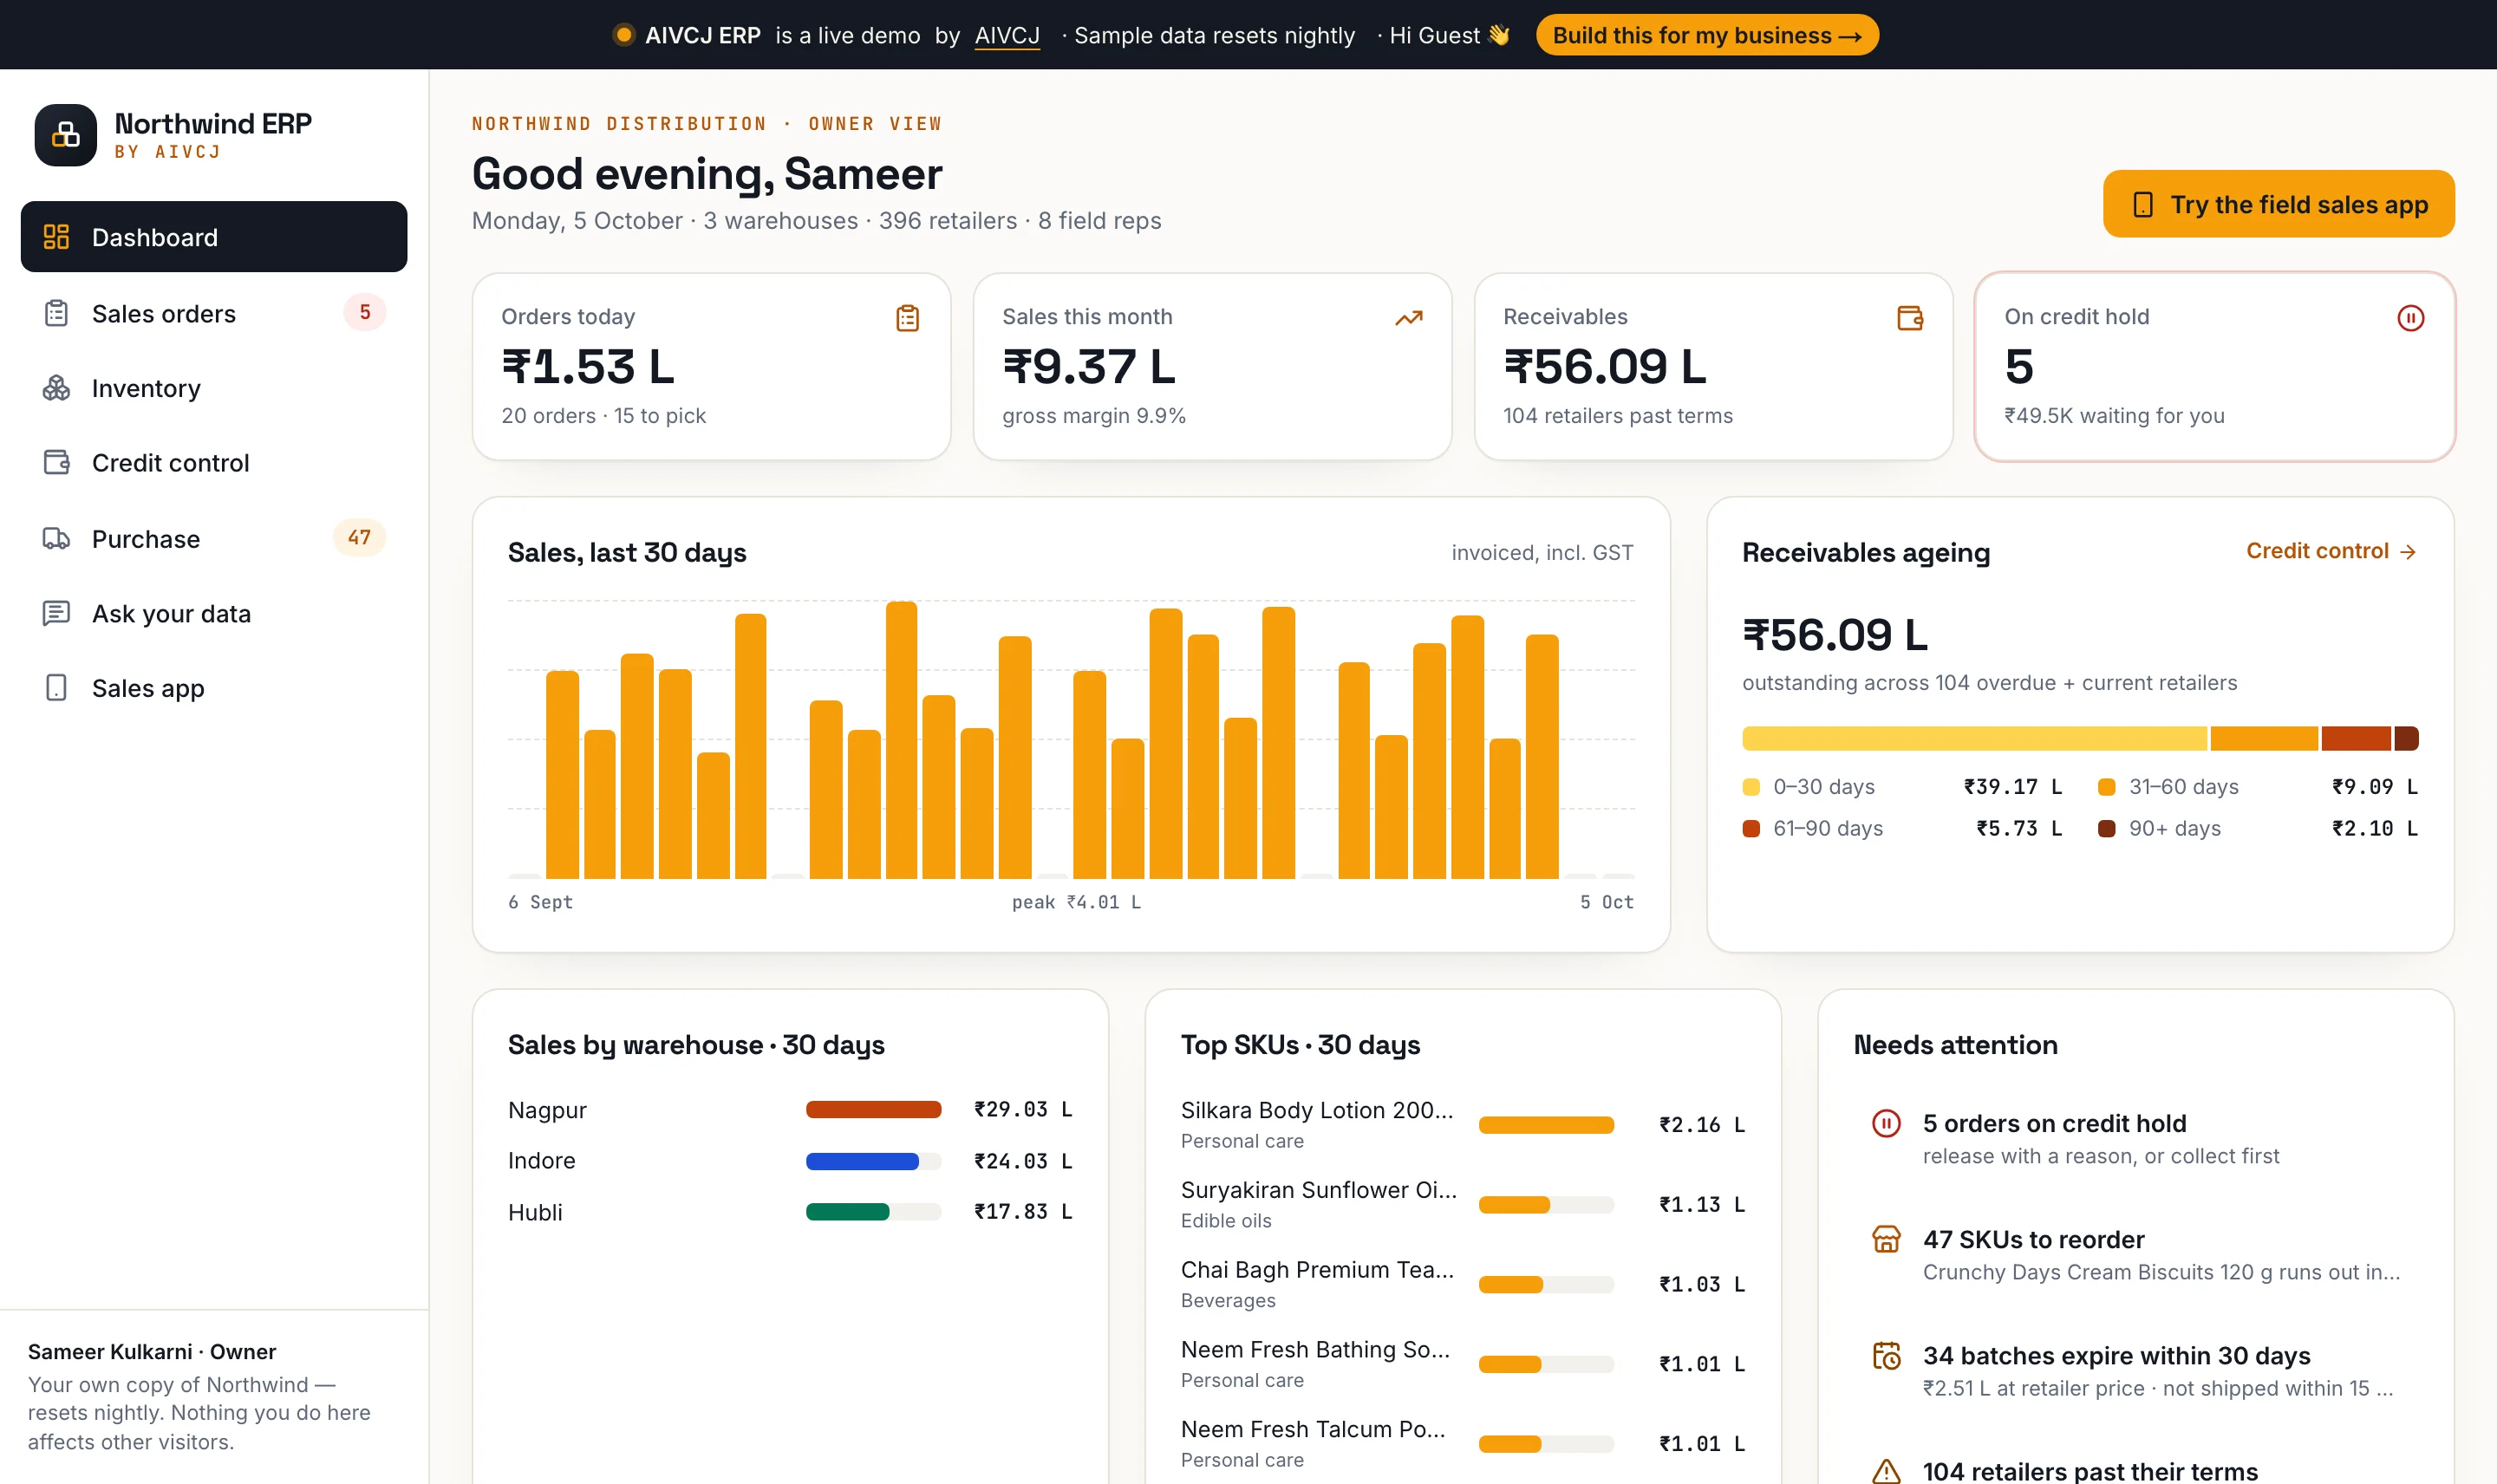 ERP y operaciones
7 min de lectura
De fotos por WhatsApp a una cartera de pedidos en vivo: un ERP y una app de campo offline para distribuidores
AIVCJ ERP sustituye el círculo Tally + Excel + WhatsApp: una app de campo que toma pedidos sin cobertura y nunca sincroniza dos veces, bloqueos por riesgo de crédito decididos en código, preparación FEFO con facturas GST y preguntas en lenguaje natural respondidas con una consulta de solo lectura que puedes ver. Medido con una prueba de sincronización con dos teléfonos y un conjunto ciego de NL a SQL.
Leer más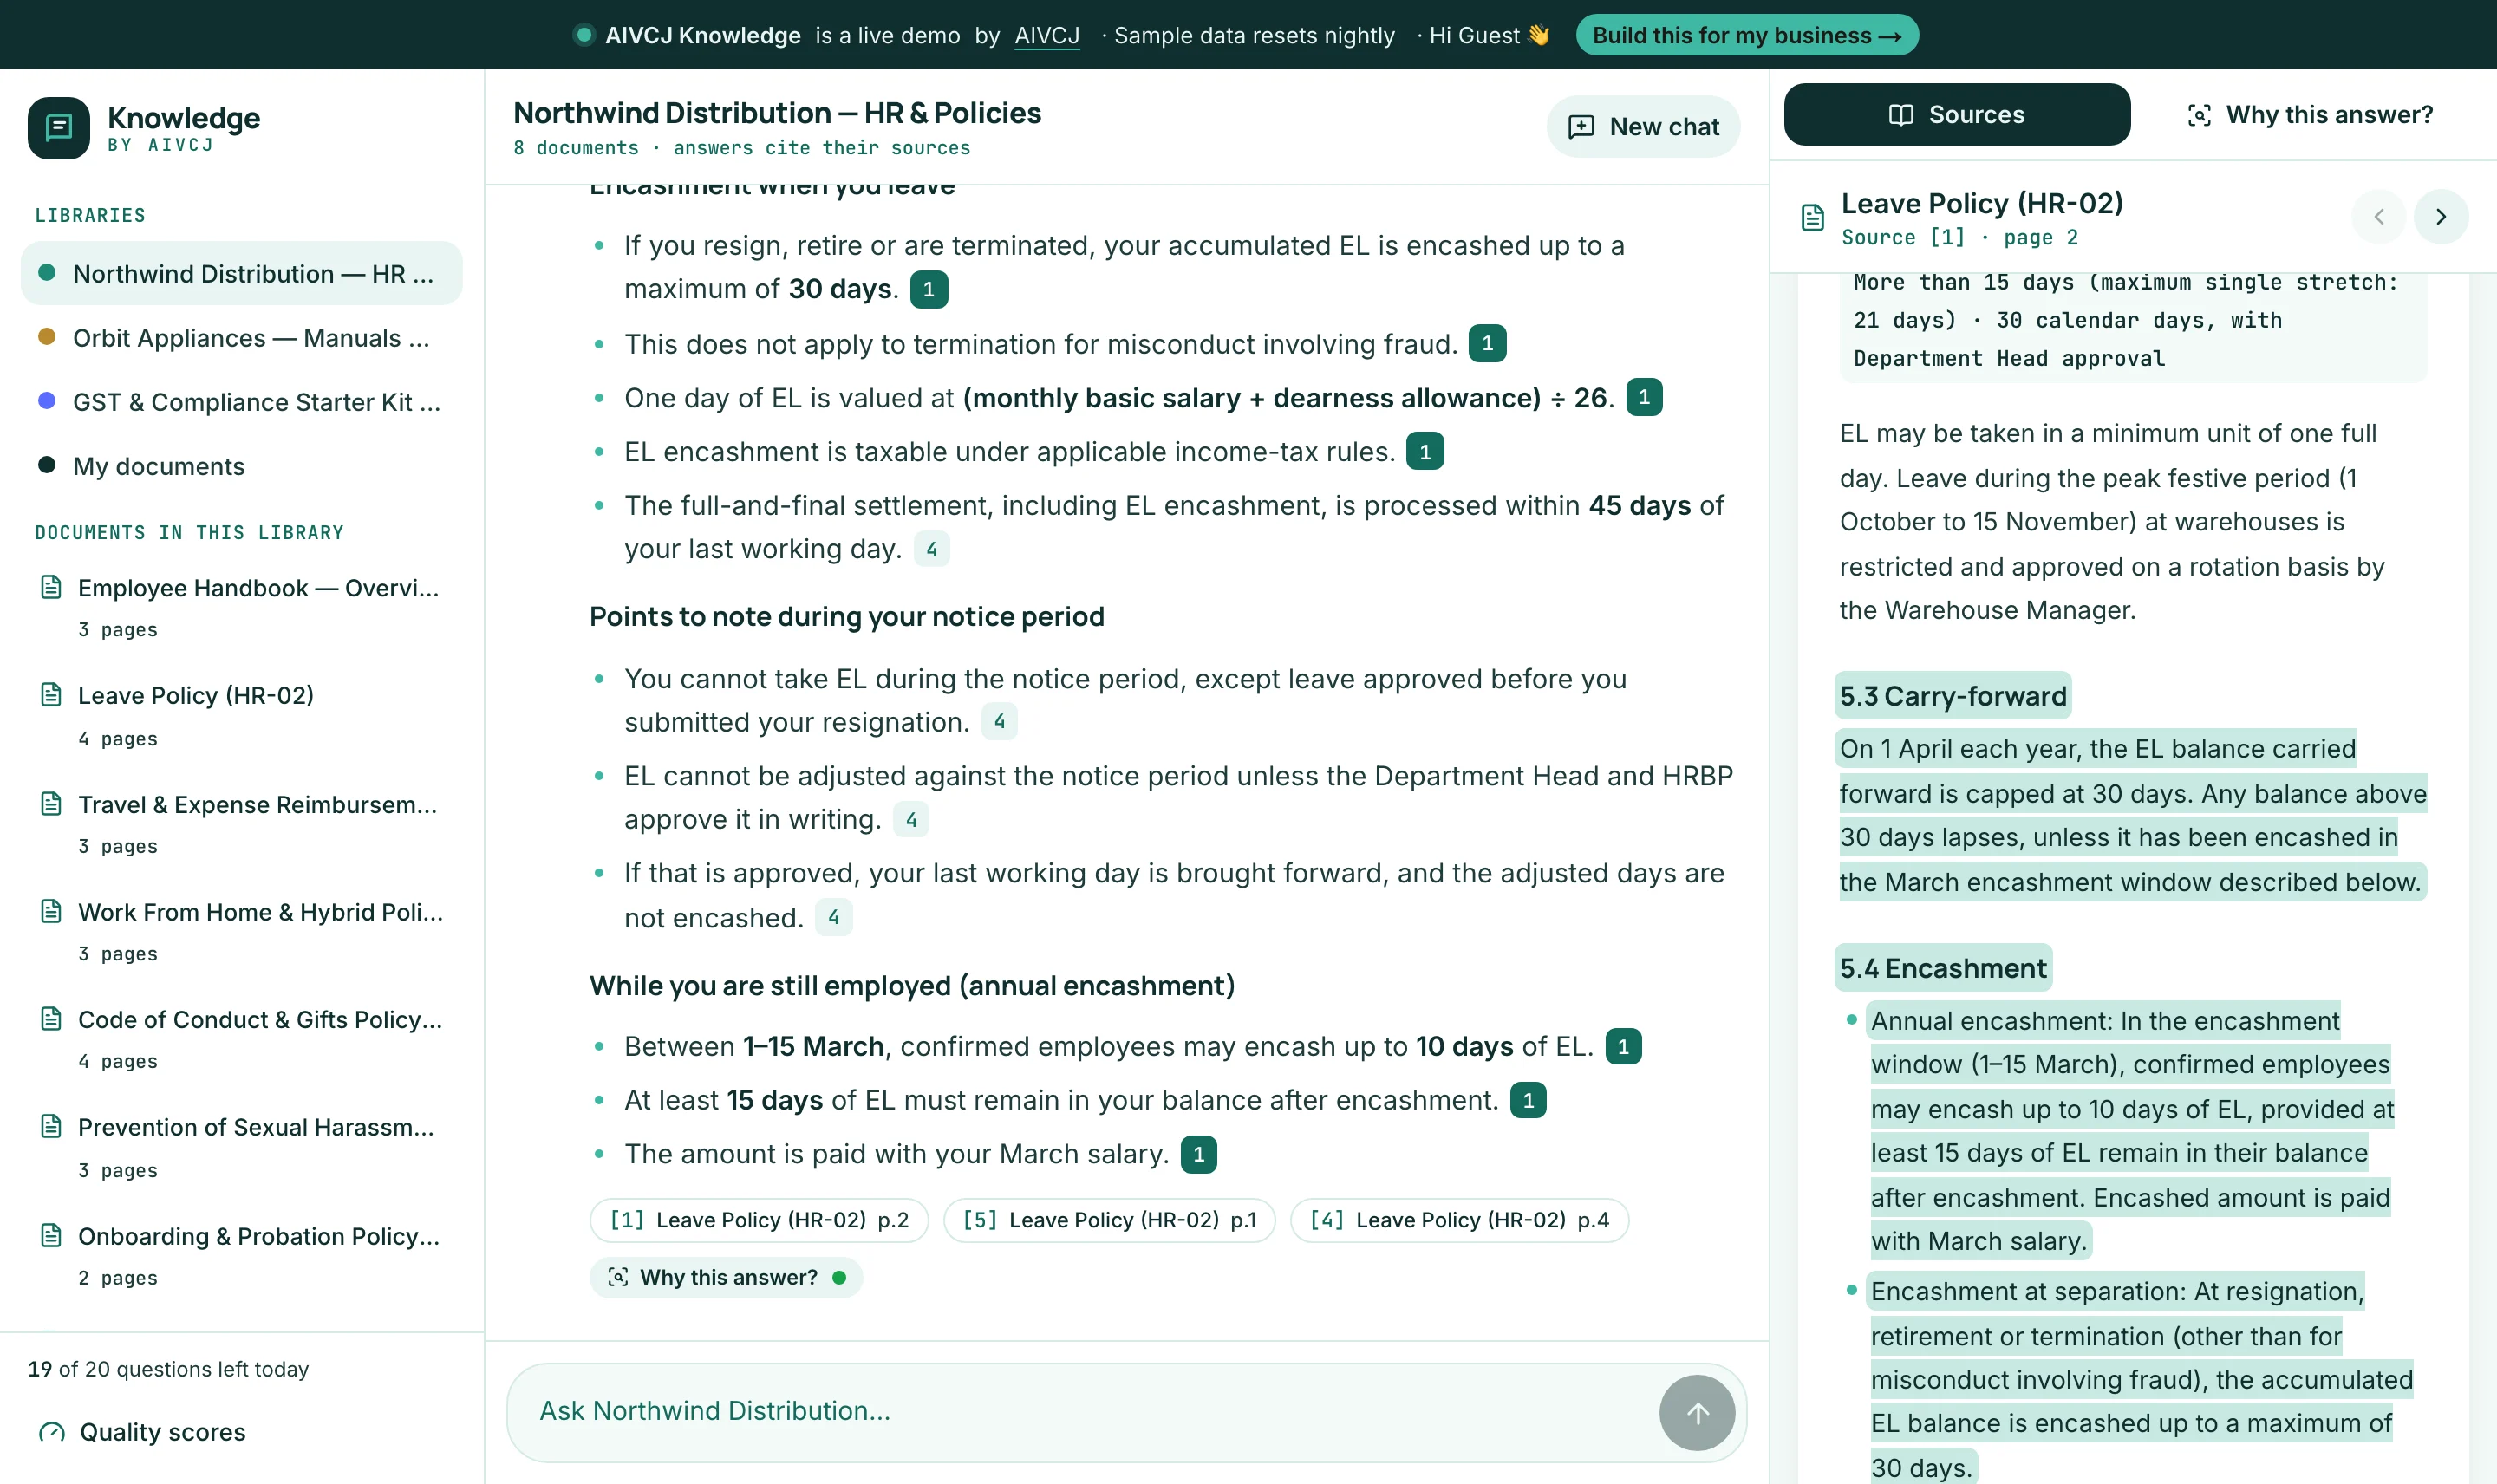 IA y RAG
5 min de lectura
Por qué la mayoría de los chatbots de empresa se inventan respuestas — y cómo construimos uno que cita sus fuentes
Entre bastidores de AIVCJ Knowledge: recuperación híbrida, planificación de consultas, una comprobación de fundamento en cada respuesta y dos conjuntos de pruebas públicos, incluido uno ciego escrito como escribe la gente de verdad. Pruébalo en vivo con documentos de ejemplo de RR. HH., producto y GST, o con tu propio PDF.
Leer más