Autoalojar un entrevistador con IA con LiveKit: la arquitectura
La IA de voz en tiempo real es una cuestión de latencia. Así combinamos LiveKit autoalojado, voz en streaming y un LLM para realizar entrevistas naturales en tus propios servidores.
Un chatbot de texto puede tardar dos segundos en responder y a nadie le importa. En una conversación de voz, una pausa de dos segundos parece que se cortó la llamada. Por eso, crear un entrevistador con IA que a los candidatos les resulte natural consiste sobre todo en recortar la latencia, manteniendo el audio sensible dentro de una infraestructura que tú controlas.
¿Por qué alojar LiveKit en tu propia infraestructura?
LiveKit es un servidor de medios WebRTC de código abierto. Alojarlo tú mismo significa que el audio y el video de los candidatos nunca pasan por una nube de medios de terceros, que eliges la región del centro de datos y que puedes superar revisiones de privacidad que bloquearían una herramienta SaaS. Además, elimina las tarifas por minuto de medios a gran escala.
El pipeline
- Sala: el candidato se une a una sala de LiveKit desde el navegador, sin instalar nada.
- Agente: un agente del lado del servidor se une a la misma sala como participante y se suscribe a la pista de audio del candidato.
- Escuchar: la conversión de voz a texto en streaming genera transcripciones parciales mientras el candidato aún habla; la detección de actividad de voz decide cuándo ha terminado.
- Pensar: el LLM recibe la transcripción junto con la rúbrica del puesto y el estado de la conversación, y devuelve en streaming la siguiente pregunta.
- Hablar: la síntesis de voz en streaming empieza a reproducir las primeras palabras antes de que se genere la frase completa.
En qué se van los milisegundos
La detección del fin de turno, el primer token del modelo y el primer byte de audio de la síntesis de voz dominan la latencia percibida. Ajustamos la detección de turnos por idioma, mantenemos los prompts compactos y aptos para caché, y hacemos streaming en cada etapa para que se solapen en lugar de hacer cola.
Justo y auditable
Cada pregunta se basa en una rúbrica estructurada, cada puntuación cita el momento de la transcripción que la justifica y las grabaciones se conservan para revisión humana. La IA filtra y documenta; las personas deciden.
En producción
LiveKit, los workers de agentes y la aplicación se ejecutan detrás de Nginx con TURN para redes restrictivas, escalado horizontal de agentes para picos de entrevistas y observabilidad de la latencia de turnos, para detectar regresiones antes de que los candidatos las noten.
- #LiveKit
- #Voice AI
- #WebRTC
- #Architecture
AI Interviewer
Entrevistas de voz en tiempo real, en tus propios servidores.
Sigue leyendo
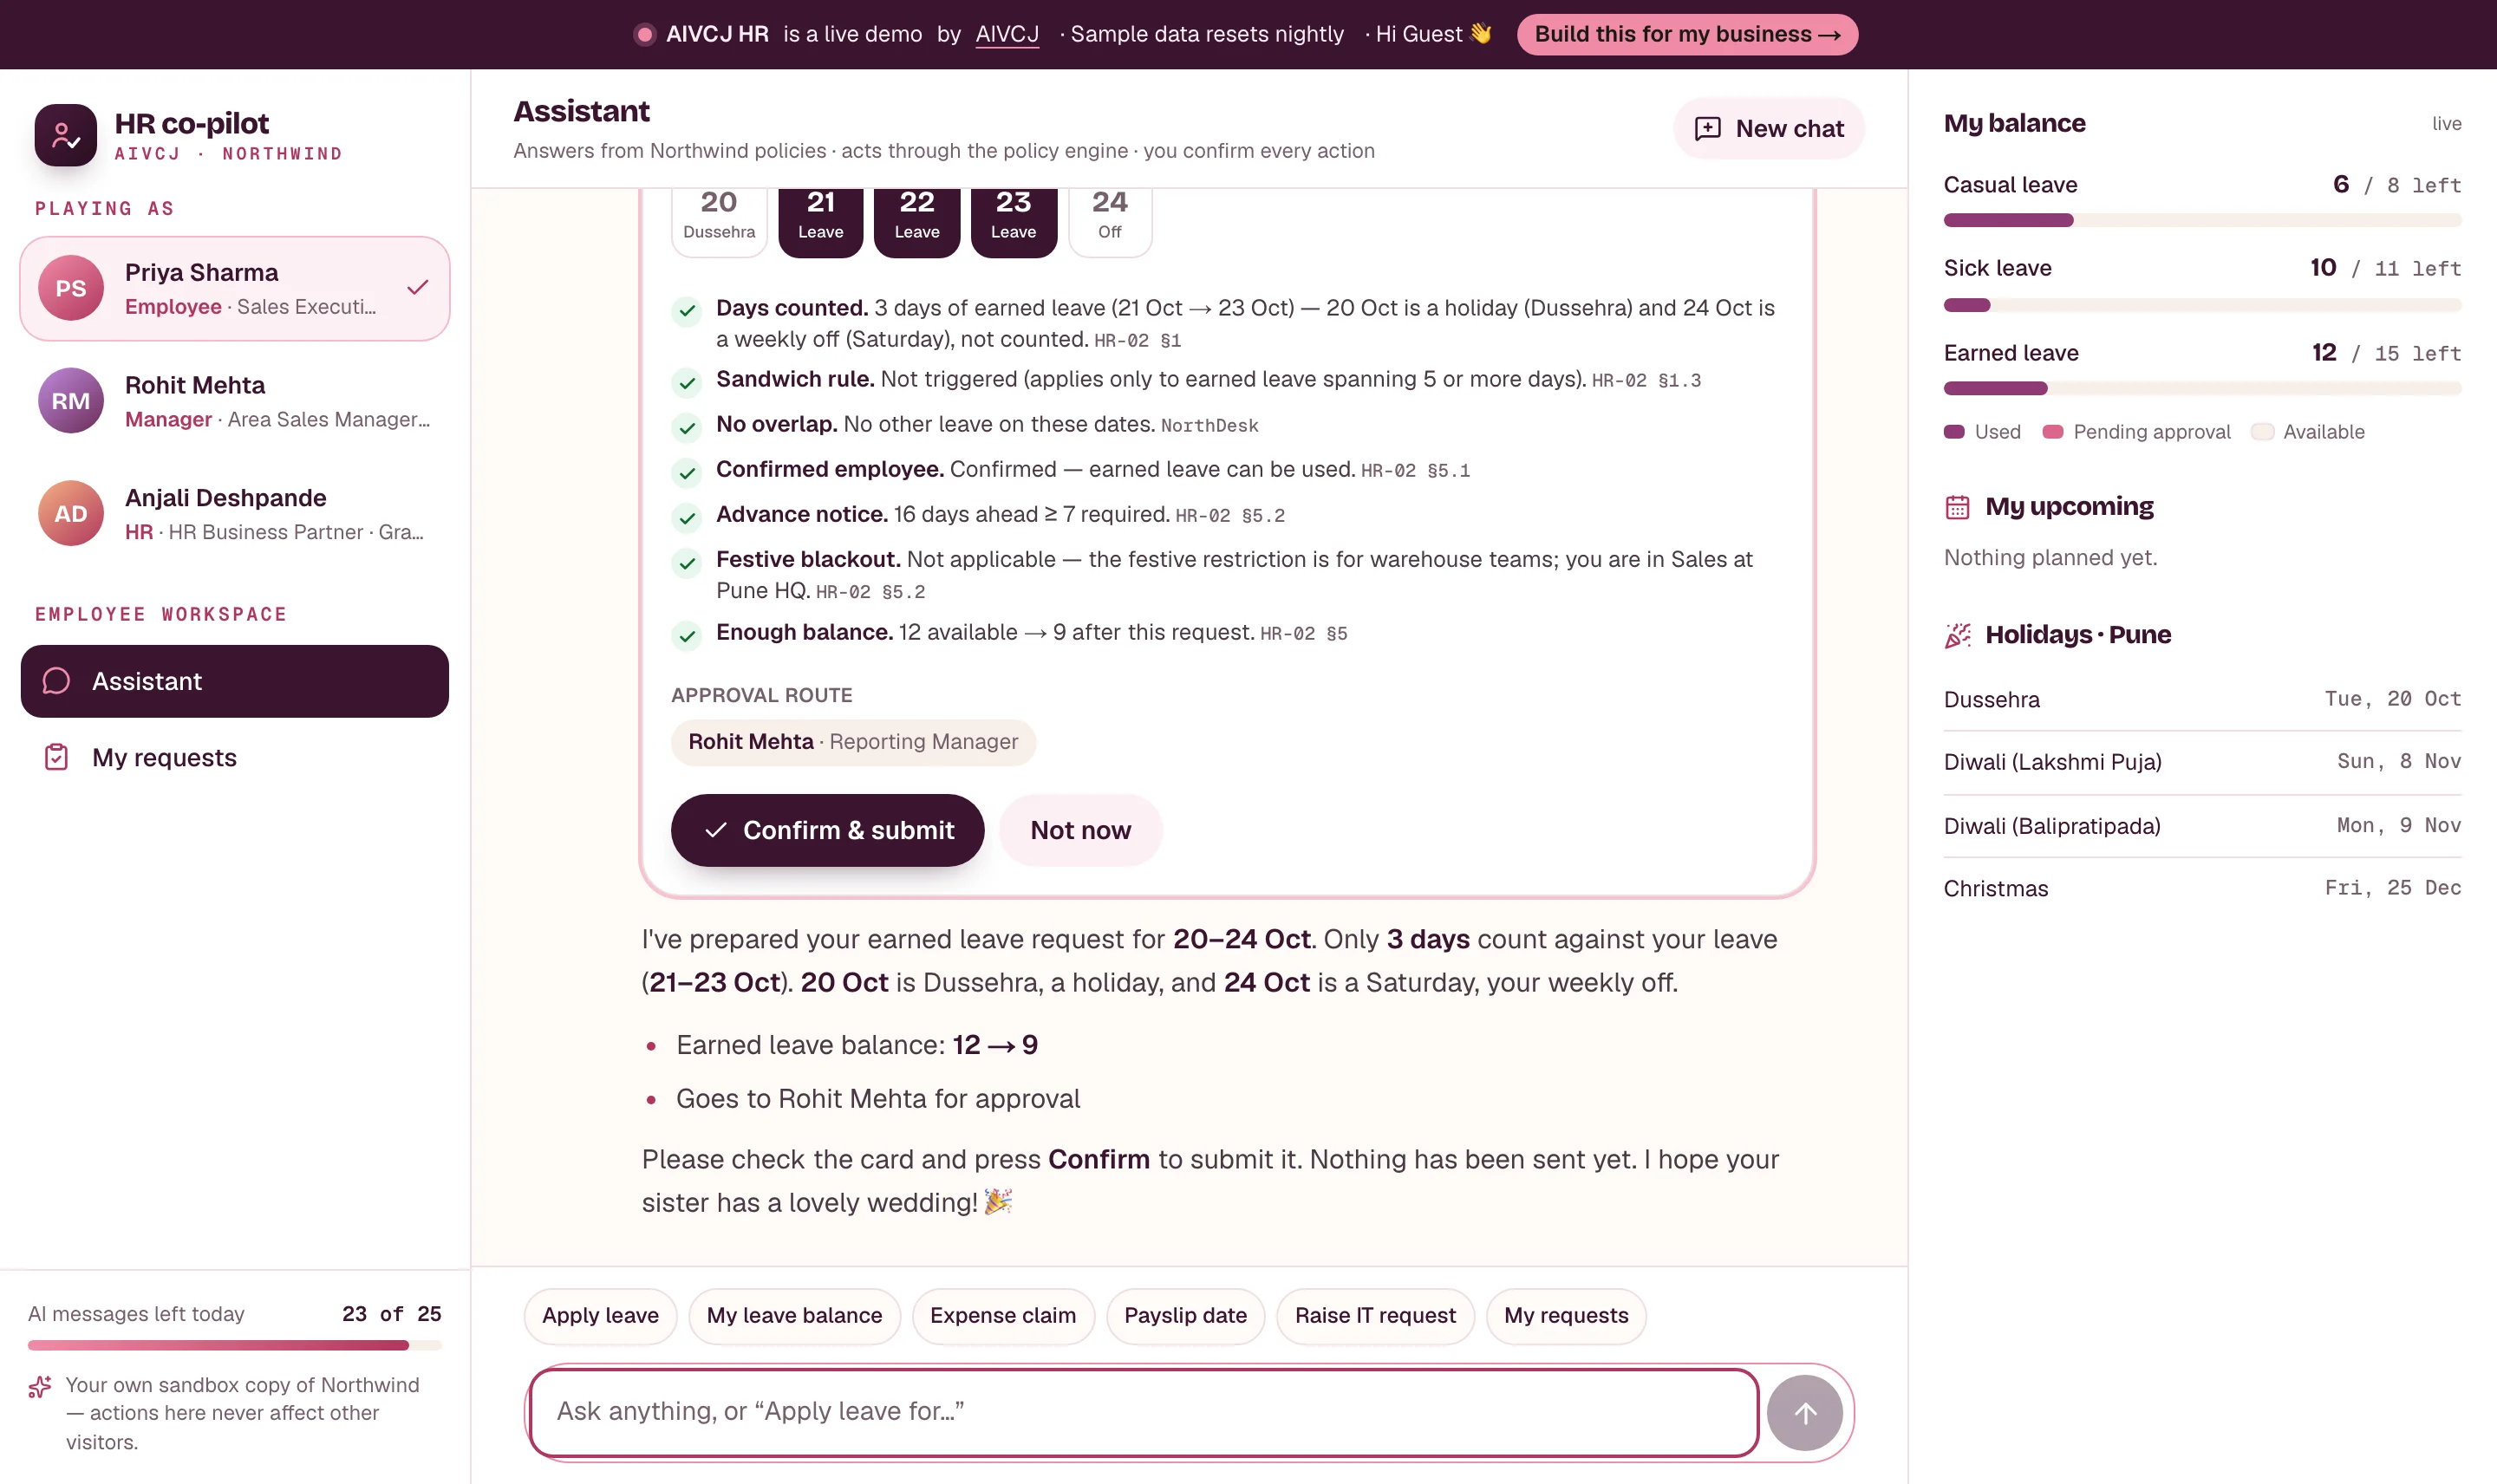 ERP y operaciones
5 min de lectura
De chatbot a compañero de trabajo: un asistente de RR. HH. que actúa de forma segura
AIVCJ HR no solo responde preguntas sobre vacaciones: solicita permisos, enruta aprobaciones y redacta cartas de RR. HH. Así dejamos que una IA actúe sin dejar que ponga las reglas: un motor de políticas en código, una tarjeta de confirmación antes de cada acción, permisos por rol y un registro de auditoría. Medido con un conjunto de pruebas guionizado y otro ciego.
Leer más2 min de lectura
¿Qué es RAG y cuándo lo necesita realmente tu negocio?
La generación aumentada por recuperación permite que la IA responda a partir de tus propios documentos en lugar de adivinar. Aquí explicamos cómo funciona, dónde brilla y las señales de que estás listo para ella.
Leer más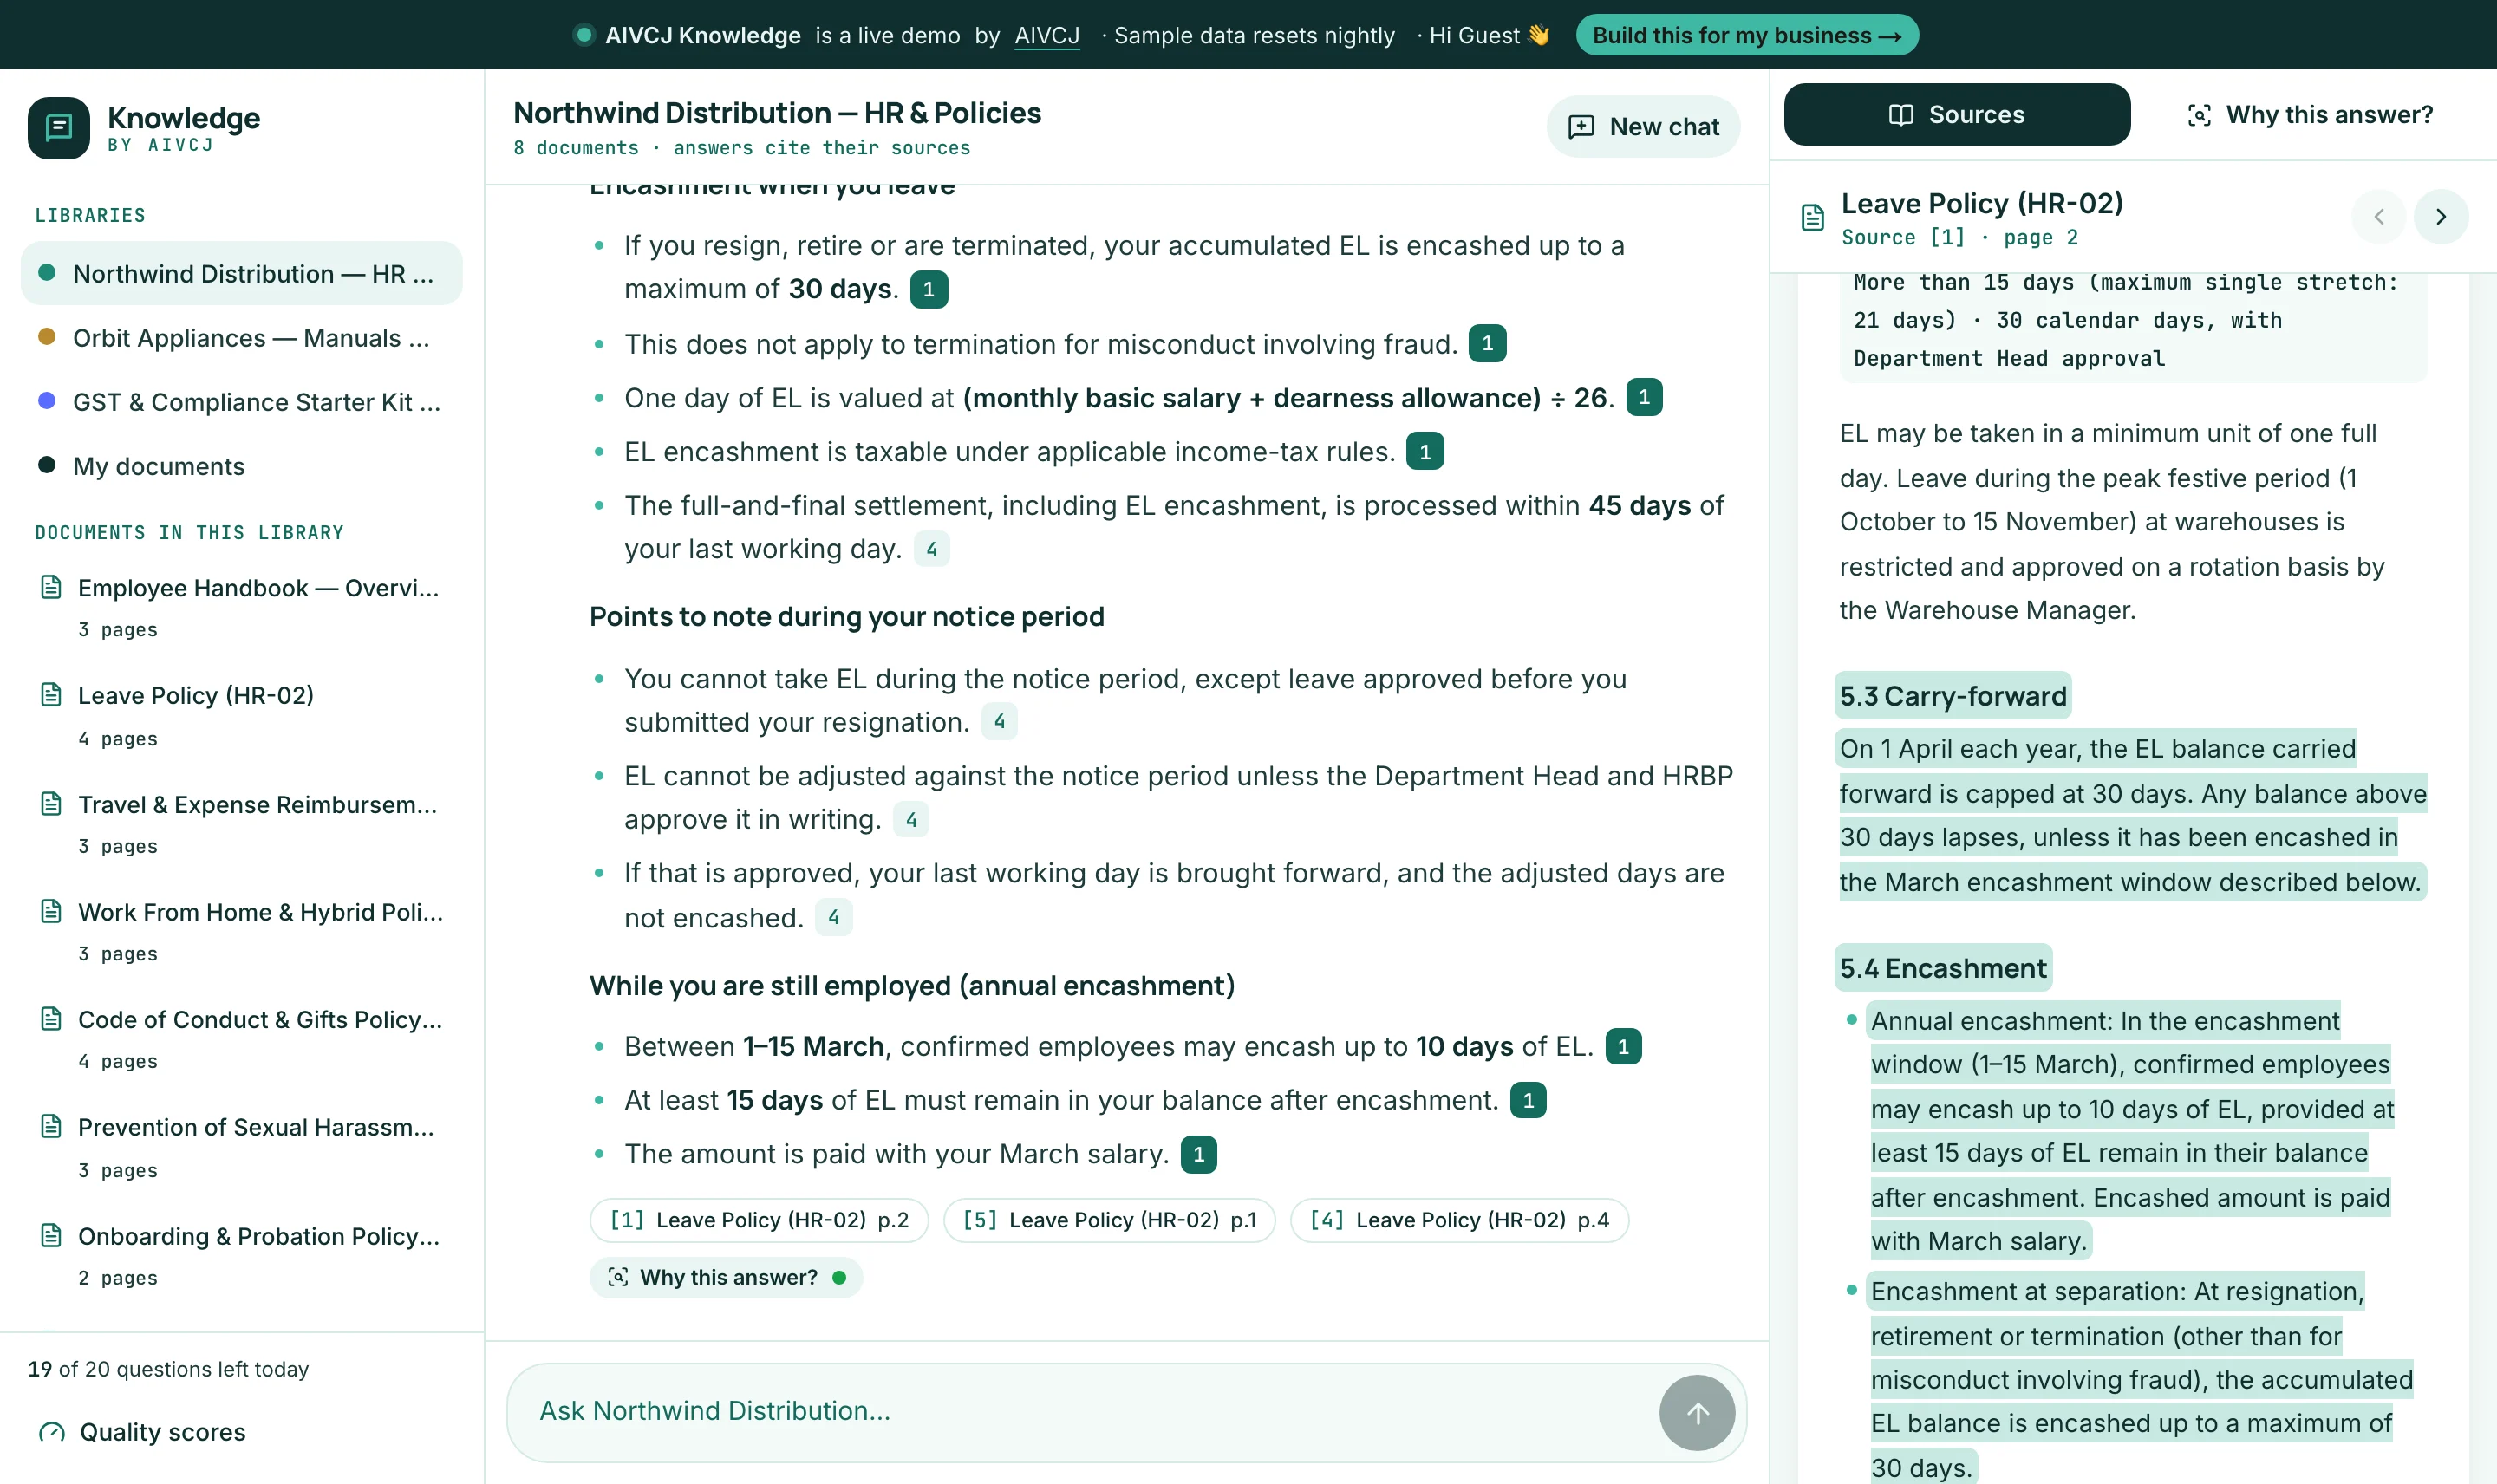 IA y RAG
5 min de lectura
Por qué la mayoría de los chatbots de empresa se inventan respuestas — y cómo construimos uno que cita sus fuentes
Entre bastidores de AIVCJ Knowledge: recuperación híbrida, planificación de consultas, una comprobación de fundamento en cada respuesta y dos conjuntos de pruebas públicos, incluido uno ciego escrito como escribe la gente de verdad. Pruébalo en vivo con documentos de ejemplo de RR. HH., producto y GST, o con tu propio PDF.
Leer más