മിക്ക കമ്പനി ചാറ്റ്ബോട്ടുകളും എന്തുകൊണ്ട് ഉത്തരങ്ങൾ കെട്ടിച്ചമയ്ക്കുന്നു — ഉറവിടം കാണിക്കുന്ന ഒന്ന് ഞങ്ങൾ എങ്ങനെ നിർമ്മിച്ചു
AIVCJ Knowledge-ന്റെ അണിയറയിൽ: ഹൈബ്രിഡ് തിരയൽ, ചോദ്യ ആസൂത്രണം, ഓരോ ഉത്തരത്തിനും അടിസ്ഥാന പരിശോധന, രണ്ട് പൊതു ടെസ്റ്റ് സെറ്റുകൾ — അതിലൊന്ന് യഥാർത്ഥ ആളുകൾ ടൈപ്പ് ചെയ്യുന്നതുപോലെ എഴുതിയ ബ്ലൈൻഡ് സെറ്റ്. സാമ്പിൾ HR, ഉൽപ്പന്ന, GST രേഖകളിലോ നിങ്ങളുടെ സ്വന്തം PDF-ലോ ലൈവായി പരീക്ഷിക്കൂ.
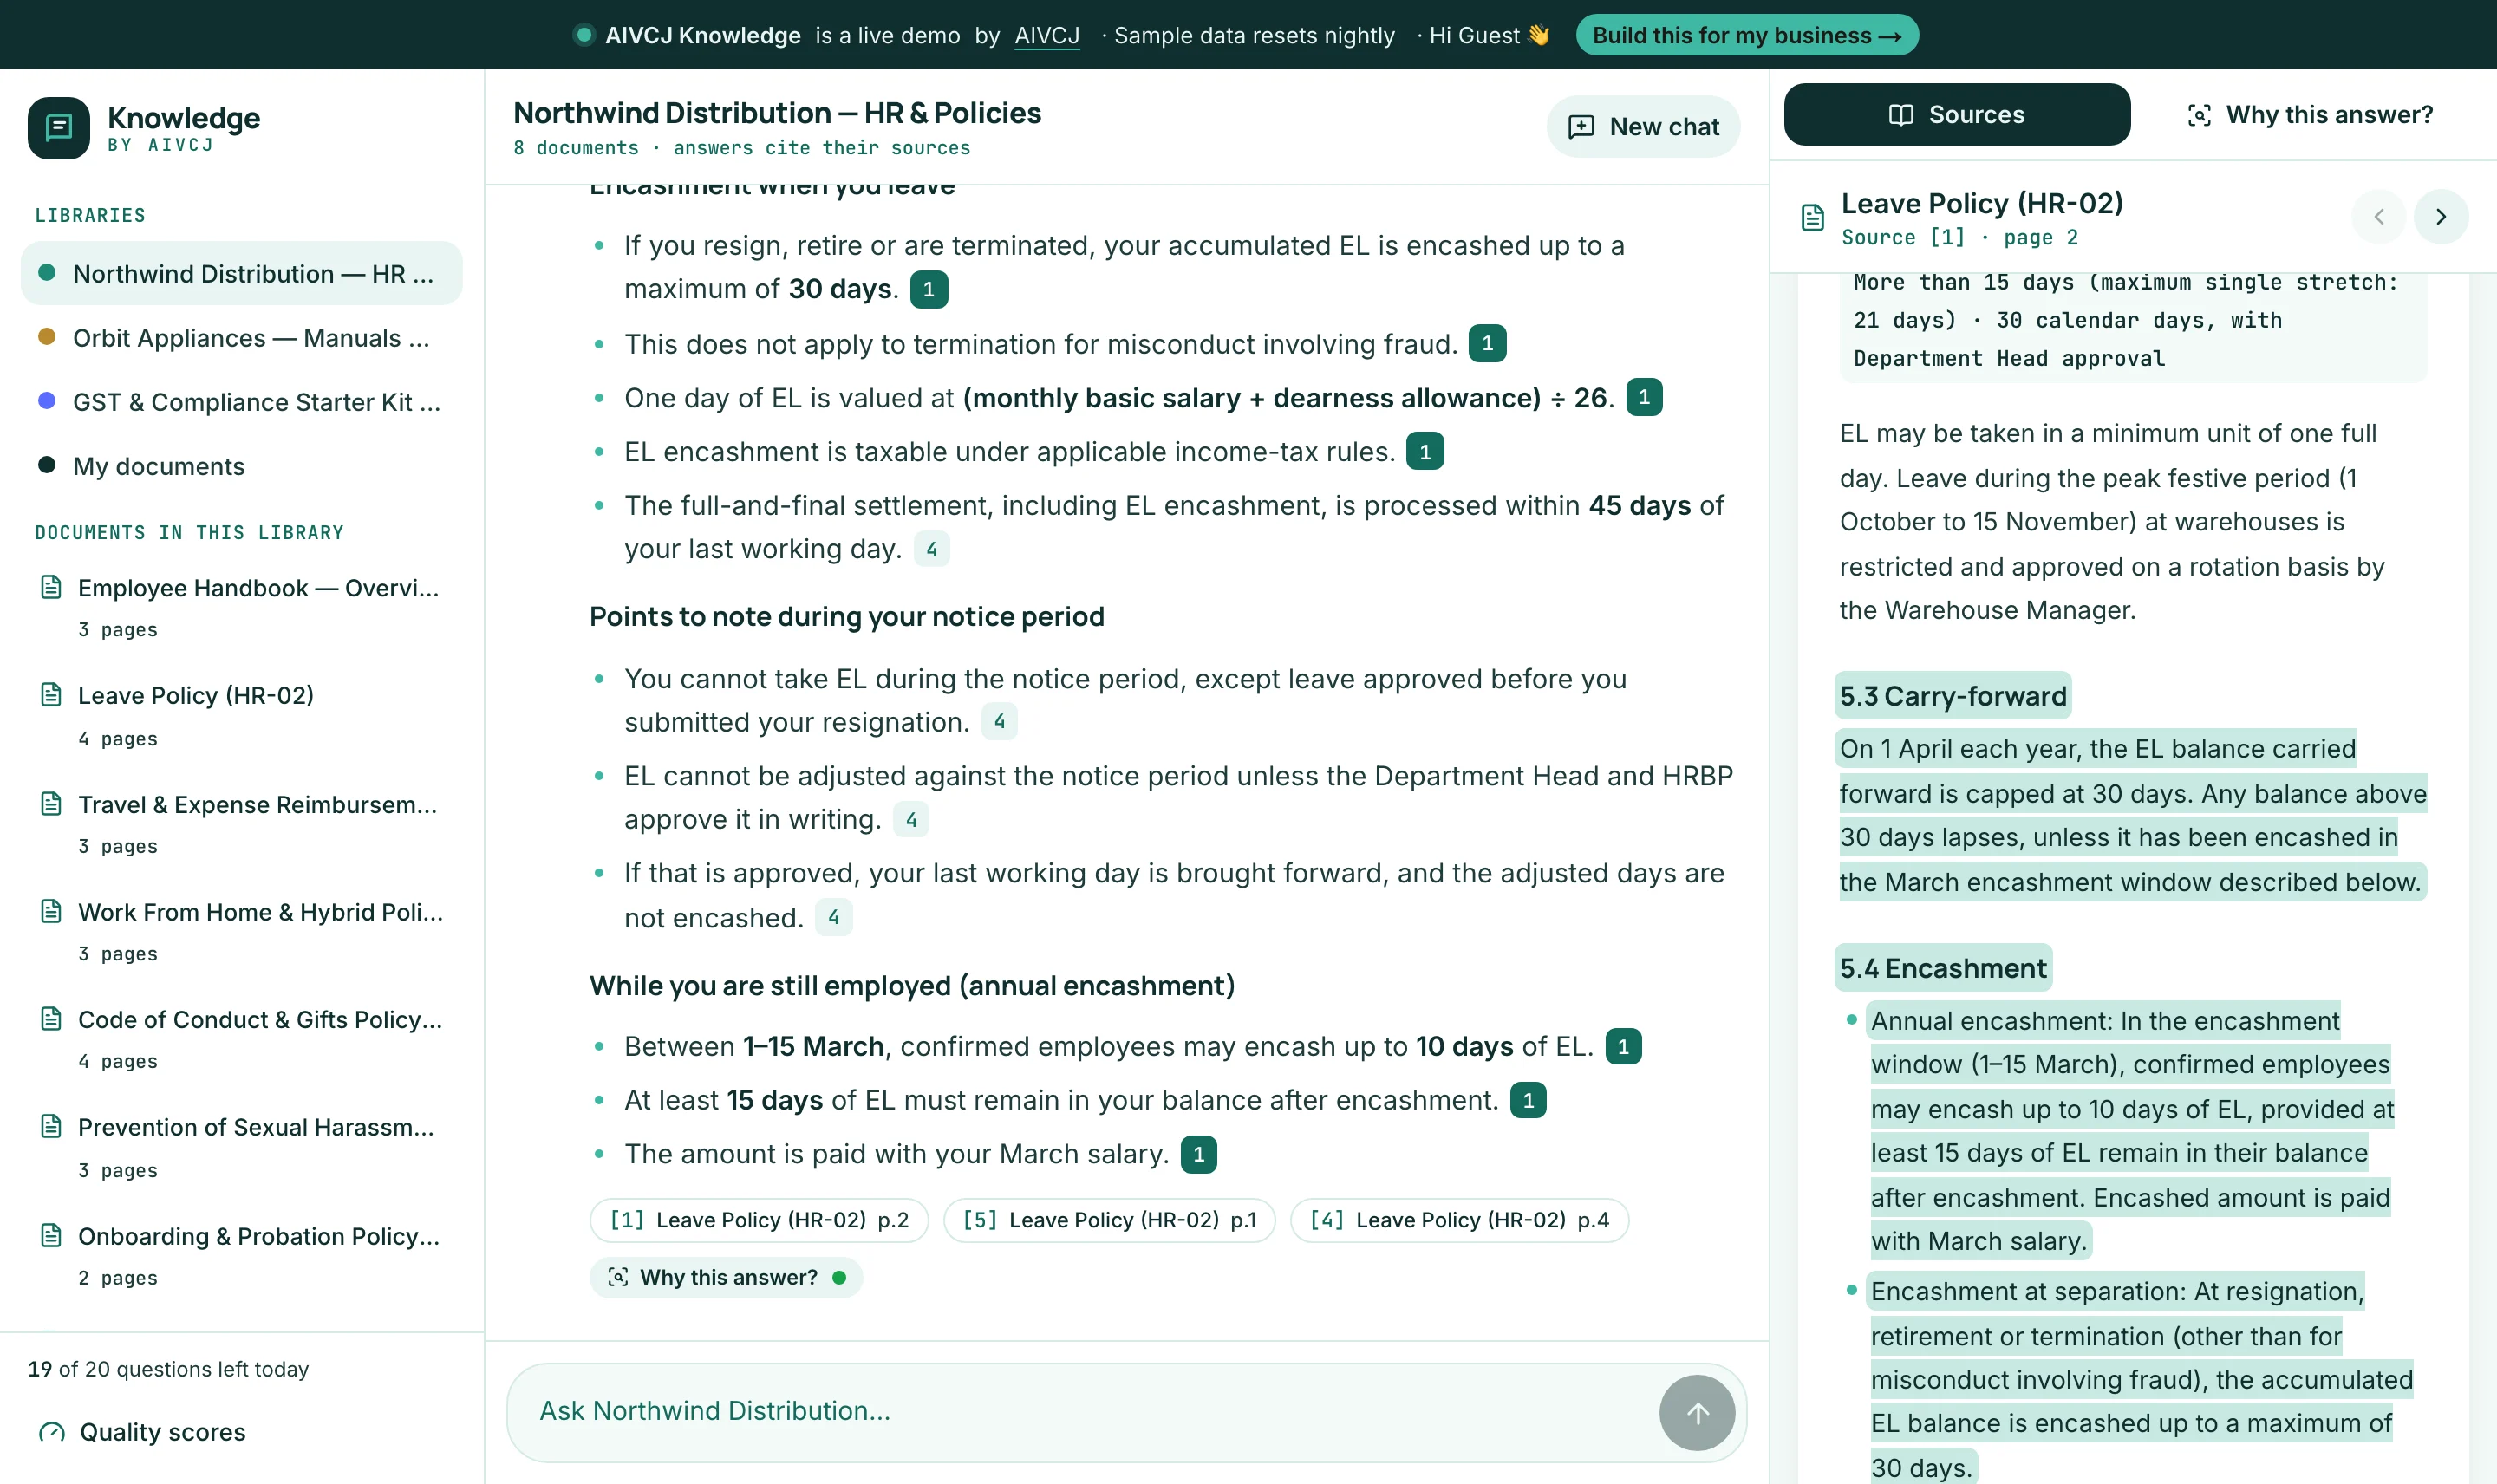
എല്ലാ കമ്പനിക്കും ഒരേ പ്രശ്നമാണ്. ഉത്തരങ്ങൾ ഉണ്ട് — ഏതെങ്കിലും അവധി നയത്തിൽ, വാറന്റി PDF-ൽ, 2023-ലെ ഏതോ SOP-ൽ — പക്ഷേ ആർക്കും കണ്ടെത്താനാകുന്നില്ല, അതിനാൽ ആളുകൾ സഹപ്രവർത്തകനോട് ചോദിക്കുന്നു, ഊഹിക്കുന്നു, അല്ലെങ്കിൽ ടിക്കറ്റ് തുറക്കുന്നു. ചാറ്റ്ബോട്ട് വ്യക്തമായ പരിഹാരമായി തോന്നും. മിക്കവയും ഒരേ കാരണത്താൽ നിരാശപ്പെടുത്തുന്നു: അറിയില്ലെങ്കിൽ പോലും അവ ആത്മവിശ്വാസത്തോടെ ഉത്തരം പറയുന്നു, ഉത്തരം എവിടെ നിന്ന് വന്നു എന്ന് ആർക്കും പരിശോധിക്കാനാകില്ല.
ബദൽ എങ്ങനെയിരിക്കും എന്ന് കാണിക്കാൻ ഞങ്ങൾ AIVCJ Knowledge നിർമ്മിച്ചു. ഇന്നുതന്നെ തുറക്കാവുന്ന ഒരു ലൈവ് ഡെമോയാണിത്: ഒരു സാമ്പിൾ ലൈബ്രറി തിരഞ്ഞെടുക്കൂ, യഥാർത്ഥ ചോദ്യം ചോദിക്കൂ, ഉത്തരത്തിലെ ഓരോ വാചകവും അത് വന്ന കൃത്യമായ ഭാഗത്തേക്ക് ചൂണ്ടുന്നു.
പ്രശ്നം: ഒഴുക്കോടെ പറയുന്നത് ശരിയായി പറയുന്നതല്ല
ഒറ്റയ്ക്കുള്ള ഒരു ഭാഷാ മോഡൽ ഓർമ്മയിൽ നിന്ന് ഉത്തരം പറയുന്നു. നിങ്ങളുടെ അവധി ക്യാരി-ഫോർവേഡ് നിയമത്തെക്കുറിച്ച് ചോദിച്ചാൽ, ആയിരക്കണക്കിന് മറ്റ് കമ്പനികളുടെ നയങ്ങളിൽ നിന്ന് വിശ്വസനീയമായ എന്തെങ്കിലും ഉണ്ടാക്കും. ലളിതമായ തിരയൽ (RAG) സഹായിക്കും, പക്ഷേ ലളിതമായ പതിപ്പുകൾ പ്രവചനീയമായ രീതിയിൽ പരാജയപ്പെടുന്നു:
- പല ഭാഗങ്ങളുള്ള ചോദ്യങ്ങൾ. “രണ്ട് മാസം മുമ്പ് Finance-ൽ ചേർന്നു — ആഴ്ചയിൽ രണ്ട് ദിവസം വീട്ടിൽ നിന്ന് ജോലി ചെയ്യാമോ?” — ഇതിന് ഹൈബ്രിഡ് നയവും ഒപ്പം പ്രൊബേഷൻ നിയമവും വേണം. ഒരൊറ്റ തിരയൽ രണ്ടും കണ്ടെത്തുന്നത് അപൂർവമാണ്.
- പട്ടികകളും തലക്കെട്ടുകളും വേർപിരിയുന്നു. രേഖയെ ഓരോ 900 അക്ഷരത്തിലും മുറിച്ചാൽ, അലവൻസ് പട്ടിക അത് എന്തിനെക്കുറിച്ചാണെന്ന് പറയുന്ന തലക്കെട്ടിൽ നിന്ന് വേർപിരിയും.
- സത്യസന്ധമായ “അറിയില്ല” ഇല്ല. ശരിയായ ഭാഗം കിട്ടാത്തപ്പോൾ മോഡൽ വിടവ് സ്വയം നിറയ്ക്കുന്നു.
- പരിശോധിക്കാൻ വഴിയില്ല. ഉദ്ധരണികളില്ലാതെ തെറ്റായ ഉത്തരം ശരിയായ ഉത്തരം പോലെ തന്നെ തോന്നും.
AIVCJ Knowledge എങ്ങനെ പ്രവർത്തിക്കുന്നു
- ഘടന മനസ്സിലാക്കിയുള്ള ഉൾപ്പെടുത്തൽ. രേഖകൾ (PDF, DOCX, TXT) അവയുടെ സ്വന്തം ഘടന അനുസരിച്ച് വിഭജിക്കപ്പെടുന്നു: തലക്കെട്ടുകൾ അവയുടെ ഉള്ളടക്കത്തോടൊപ്പം നിൽക്കുന്നു, പട്ടികകൾ പൂർണ്ണമായി നിലനിൽക്കുന്നു, ഓരോ ഭാഗവും അതിന്റെ രേഖയും വിഭാഗവും ഓർക്കുന്നു. ആ സന്ദർഭം ഭാഗത്തോടൊപ്പം എംബെഡ് ചെയ്യുന്നതിനാൽ, പട്ടികയിലെ ഒരു വരിക്ക് പോലും അത് യാത്രാ നയത്തിന്റെ അലവൻസ് വിഭാഗത്തിന്റേതാണെന്ന് “അറിയാം”.
- ചോദ്യ ആസൂത്രണം. ഒരു ചെറിയ, വേഗതയേറിയ മോഡൽ ഓരോ ചോദ്യവും അതിന് ആവശ്യമായ പ്രത്യേക വസ്തുതകളായി വിഭജിക്കുന്നു — ജീവനക്കാരന്റെ ഗ്രേഡ്, നഗരത്തിന്റെ ടിയർ, അലവൻസ് പട്ടിക — ഓരോന്നും സ്വന്തം തിരയലാകുന്നു.
- ഹൈബ്രിഡ് തിരയൽ. ഓരോ തിരയലും PostgreSQL-നുള്ളിൽ രണ്ട് രീതിയിൽ പ്രവർത്തിക്കുന്നു: അർത്ഥം വഴി (pgvector എംബെഡിംഗുകൾ), കൃത്യമായ വാക്കുകൾ വഴി (ഫുൾ-ടെക്സ്റ്റ് തിരയൽ). ഫലങ്ങൾ reciprocal-rank fusion വഴി ലയിപ്പിക്കുന്നു, ചോദ്യത്തിന്റെ ഓരോ ഭാഗത്തിനും ഒരു സ്ഥാനം ഉറപ്പ്.
- ഉറവിടങ്ങളിൽ നിന്ന് മാത്രം ഉത്തരം. കണ്ടെത്തിയ ഭാഗങ്ങളിൽ നിന്ന് മാത്രം Claude ഉത്തരം എഴുതുന്നു, ഓരോ അവകാശവാദത്തിനും [1], [2]… എന്ന് ഉദ്ധരിച്ച്. രേഖകളിൽ ഇല്ലെങ്കിൽ അത് വ്യക്തമായി പറയുന്നു.
- അടിസ്ഥാന പരിശോധന. രണ്ടാമത്തെ ഘട്ടം പൂർത്തിയായ ഉത്തരത്തെ അതിന്റെ ഉറവിടങ്ങളുമായി താരതമ്യം ചെയ്ത് പൂർണ്ണ പിന്തുണയുള്ളത്, ഭാഗിക പിന്തുണയുള്ളത് അല്ലെങ്കിൽ രേഖകളിൽ ഇല്ല എന്ന് അടയാളപ്പെടുത്തുന്നു — ഉപയോക്താവിന് കാണാം.
ഡെമോയിൽ നിങ്ങൾ കാണുന്നത്
- ക്ലിക്ക് ചെയ്യാവുന്ന ഉദ്ധരണികൾ — ഉറവിട പേജ് തുറന്ന് കൃത്യമായ ഭാഗം ഹൈലൈറ്റ് ചെയ്യുന്നു.
- “എന്തുകൊണ്ട് ഈ ഉത്തരം?” — കണ്ടെത്തിയ ഓരോ ഭാഗവും അതിന്റെ അർത്ഥ, കീവേഡ്, ഫ്യൂഷൻ സ്കോറുകളോടെ; ഏതൊക്കെ ഉദ്ധരിച്ചു, അടിസ്ഥാന വിധി, എടുത്ത സമയം, ഉപയോഗിച്ച ടോക്കണുകൾ.
- നിങ്ങളുടെ സ്വന്തം രേഖ. ഒരു PDF അല്ലെങ്കിൽ Word ഫയൽ അപ്ലോഡ് ചെയ്യൂ (നിങ്ങൾക്ക് മാത്രം, എല്ലാ രാത്രിയും മായ്ക്കും), നിമിഷങ്ങൾക്കുള്ളിൽ അതിനെക്കുറിച്ച് ചോദിക്കൂ.
- ഒരു ഗുണനിലവാര പേജ് — ചോദ്യം തിരിച്ച് പൂർണ്ണ ടെസ്റ്റ് ഫലങ്ങളോടെ.
ഊഹമല്ല, അളവ് — പരിമിതികളെക്കുറിച്ച് സത്യസന്ധമായി
ഓരോ സാമ്പിൾ ലൈബ്രറിക്കും രണ്ട് ടെസ്റ്റ് സെറ്റുകളുണ്ട്, ഓരോ ഉത്തരവും ഉറവിടങ്ങളോടുള്ള വിശ്വസ്തതയും ചോദ്യത്തോടുള്ള പ്രസക്തിയും പരിശോധിക്കുന്നു.
- ഗോൾഡൻ സെറ്റ് (45 ചോദ്യങ്ങൾ). രേഖകൾക്കൊപ്പം എഴുതിയത്; പല രേഖകൾ വേണ്ട ചോദ്യങ്ങളും രേഖകൾ മനഃപൂർവം ഉത്തരം നൽകാത്ത ചോദ്യങ്ങളും ഉൾപ്പെടെ. ട്യൂണിംഗിൽ ഇത് ഉപയോഗിച്ചു, അതിനാൽ ഇത് ഞങ്ങളെ മെച്ചപ്പെടുത്തി കാണിക്കുന്നു. ഞങ്ങളുടെ ആദ്യ പതിപ്പ് — നിശ്ചിത വലിപ്പമുള്ള കഷണങ്ങളും ഓരോ ചോദ്യത്തിനും ഒരു തിരയലും — 45-ൽ 40, 91–93% വിശ്വസ്തത; എല്ലാ പിഴവുകളും പല ഭാഗങ്ങളുള്ള ചോദ്യങ്ങളിലായിരുന്നു. ഘടന അടിസ്ഥാനമാക്കിയ കഷണങ്ങൾ, സന്ദർഭ എംബെഡിംഗുകൾ, ചോദ്യ ആസൂത്രണം എന്നിവ അതിനെ റണ്ണുകളിൽ 45-ൽ 42–45, 98–100% വിശ്വസ്തതയിലെത്തിച്ചു.
- ബ്ലൈൻഡ് സെറ്റ് (20 ചോദ്യങ്ങൾ). പിന്നീട് മറ്റൊരാൾ ആളുകൾ ശരിക്കും ടൈപ്പ് ചെയ്യുന്നതുപോലെ എഴുതിയത് — ഹിംഗ്ലീഷ്, അക്ഷരത്തെറ്റുകൾ, അവ്യക്തമായ വാക്കുകൾ, രണ്ട് രേഖകൾ വേണ്ട ചോദ്യങ്ങൾ — ട്യൂണിംഗിന് ഒരിക്കലും ഉപയോഗിച്ചിട്ടില്ല: റണ്ണുകളിൽ 20-ൽ 19–20, 95–96% വിശ്വസ്തത. ഒരു റണ്ണിലെ പിഴവ് പഠിക്കേണ്ടതാണ്: കമ്പനി ലാപ്ടോപ്പ് ക്യാബിൽ മറന്നാൽ എന്തു ചെയ്യണമെന്ന് (ഹിംഗ്ലീഷിൽ) ചോദിച്ചപ്പോൾ, 24×7 IT Security ലൈനിന് പകരം സാധാരണ IT ഹെൽപ്ഡെസ്ക് പറഞ്ഞു, പോലീസ് പരാതി ഘട്ടം ഒഴിവാക്കി — ബ്ലൈൻഡ് സെറ്റ് കണ്ടെത്താൻ വേണ്ടി തന്നെയുള്ള വിടവ്.
മറച്ചുവെക്കുന്നതിനേക്കാൾ പറയാൻ ആഗ്രഹിക്കുന്ന രണ്ട് മുന്നറിയിപ്പുകൾ: റഫറൻസ് ഉത്തരങ്ങളുമായി താരതമ്യം ചെയ്ത് ഒരു AI ജഡ്ജ് (Claude) ആണ് വിലയിരുത്തുന്നത് — അസിസ്റ്റന്റിന്റെ അതേ മോഡൽ കുടുംബം — ഫലങ്ങൾ മനുഷ്യർ പരിശോധിച്ചിട്ടില്ല; ഞങ്ങളുടെ സാമ്പിൾ രേഖകൾ മിക്ക യഥാർത്ഥ കമ്പനി ഫയലുകളേക്കാളും വൃത്തിയുള്ളതാണ്. സംഖ്യകളെ സൂചനയായി കാണുക. ഓരോ ചോദ്യവും ഉത്തരവും ഗ്രേഡും ഗുണനിലവാര പേജിൽ പൊതുവായുണ്ട്.
അത്രതന്നെ പ്രധാനം: രേഖകളിൽ ഇല്ലാത്ത ചോദ്യങ്ങൾക്ക് സത്യസന്ധമായ “ഇത് രേഖകളിൽ കണ്ടെത്താനായില്ല” ലഭിക്കുന്നു — കെട്ടിച്ചമച്ചതല്ല.
ഇതേ അച്ചടക്കമാണ് ഞങ്ങൾ ക്ലയന്റ് പ്രോജക്ടുകളിലേക്ക് കൊണ്ടുവരുന്നത്: ആദ്യ ദിവസം മുതൽ യഥാർത്ഥ ചോദ്യങ്ങളുടെ ടെസ്റ്റ് സെറ്റ്, prompt, മോഡൽ അല്ലെങ്കിൽ രേഖ മാറുമ്പോഴെല്ലാം വീണ്ടും പ്രവർത്തിപ്പിക്കുന്നു — ഗുണനിലവാരം ഒരു തോന്നലല്ല, ട്രാക്ക് ചെയ്യാവുന്ന സംഖ്യയാകാൻ.
നിങ്ങളുടെ ഡാറ്റയിൽ പ്രവർത്തിപ്പിക്കൽ
ഞങ്ങൾ ക്ലയന്റുകൾക്കായി സജ്ജമാക്കുന്ന അതേ സ്റ്റാക്കിലാണ് ഡെമോ പ്രവർത്തിക്കുന്നത്: Next.js, pgvector ഉള്ള PostgreSQL, Claude — നിങ്ങൾ തിരഞ്ഞെടുക്കുന്ന ഇൻഫ്രാസ്ട്രക്ചറിൽ, സെൻസിറ്റീവ് രേഖകൾക്കായി നിങ്ങളുടെ സ്വന്തം സെർവറുകൾ ഉൾപ്പെടെ. സാധാരണയായി ഒരു ഉയർന്ന അളവിലുള്ള വർക്ക്ഫ്ലോ (HR ചോദ്യങ്ങൾ, ഉൽപ്പന്ന പിന്തുണ അല്ലെങ്കിൽ ആന്തരിക SOP-കൾ), അമ്പത് യഥാർത്ഥ ചോദ്യങ്ങൾ, മാസങ്ങളല്ല ആഴ്ചകളിൽ അളന്ന ഒരു പൈലറ്റ് എന്നിവയോടെ ആരംഭിക്കുന്നു. വളരുന്നതനുസരിച്ച് കണക്ടറുകൾ (Google Drive, SharePoint, Notion), രേഖാതല അനുമതികൾ, ഒരു WhatsApp ചാനൽ എന്നിവ ചേർക്കൂ.
- #RAG
- #Case study
- #pgvector
- #Claude
- #Evaluation
പതിവ് ചോദ്യങ്ങൾ
01ഇത് ഞങ്ങളുടെ സ്വന്തം രേഖകളിൽ പ്രവർത്തിക്കുമോ?
02ഉത്തരം രേഖകളിൽ ഇല്ലെങ്കിൽ എന്ത് സംഭവിക്കും?
03ഇത് ഞങ്ങളുടെ സ്വന്തം സെർവറുകളിൽ പ്രവർത്തിപ്പിക്കാമോ?
AI & RAG ആപ്ലിക്കേഷനുകൾ
നിങ്ങളുടെ ഡാറ്റയിൽ നിന്ന് ഉത്തരം നൽകുന്ന — അത് ഉദ്ധരിക്കുകയും ചെയ്യുന്ന — അസിസ്റ്റന്റുകൾ.
വായന തുടരൂ
 ERP & ഓപ്പറേഷൻസ്
3 മിനിറ്റ് വായന
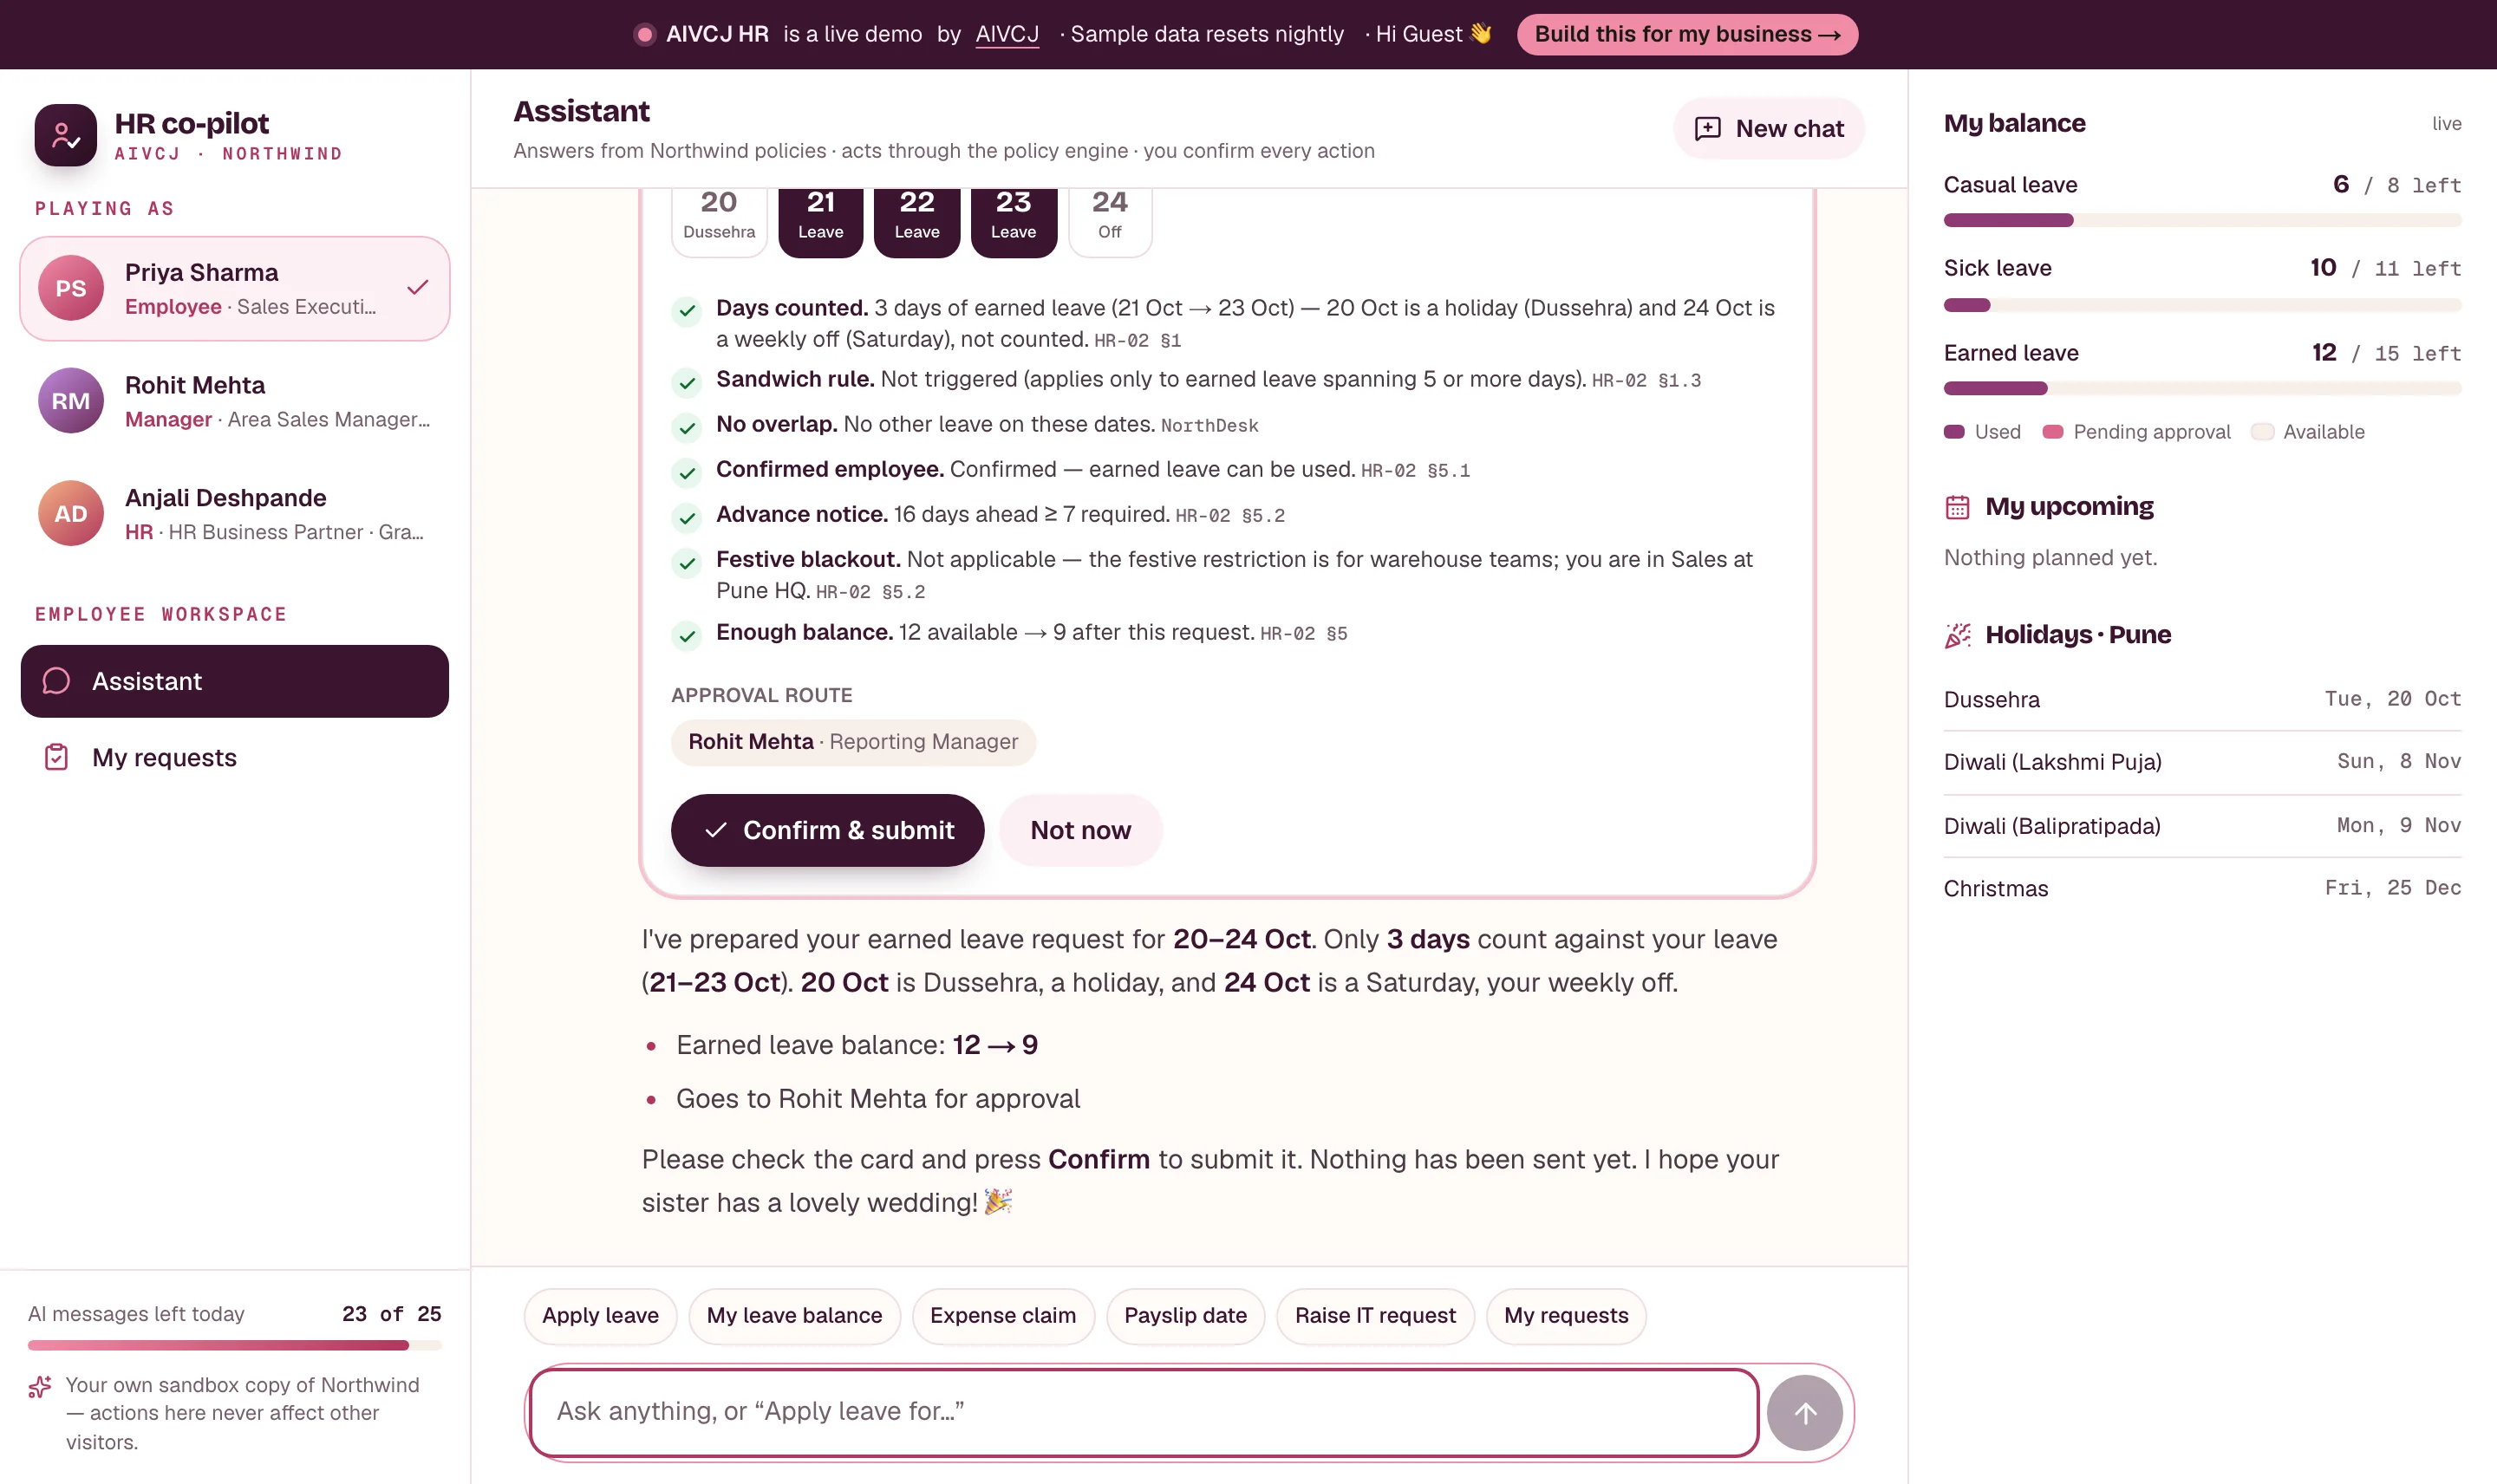
ചാറ്റ്ബോട്ടിൽ നിന്ന് സഹപ്രവർത്തകനിലേക്ക്: സുരക്ഷിതമായി പ്രവർത്തിക്കുന്ന ഒരു HR അസിസ്റ്റന്റ്
AIVCJ HR അവധി ചോദ്യങ്ങൾക്ക് മറുപടി പറയുക മാത്രമല്ല — അവധിക്ക് അപേക്ഷിക്കുന്നു, അംഗീകാരത്തിനായി അയയ്ക്കുന്നു, HR കത്തുകളുടെ കരട് തയ്യാറാക്കുന്നു. AI-യെ പ്രവർത്തിക്കാൻ അനുവദിച്ചു, പക്ഷേ നിയമങ്ങൾ ഉണ്ടാക്കാൻ അനുവദിച്ചില്ല: കോഡിൽ പോളിസി എഞ്ചിൻ, ഓരോ പ്രവൃത്തിക്കും മുമ്പ് സ്ഥിരീകരണ കാർഡ്, റോൾ അനുസരിച്ചുള്ള അനുമതികൾ, ഓഡിറ്റ് ലോഗ്. ഒരു സ്ക്രിപ്റ്റഡ് ടെസ്റ്റ് സെറ്റിലും ഒരു ബ്ലൈൻഡ് സെറ്റിലും അളന്നു.
കൂടുതൽ വായിക്കൂ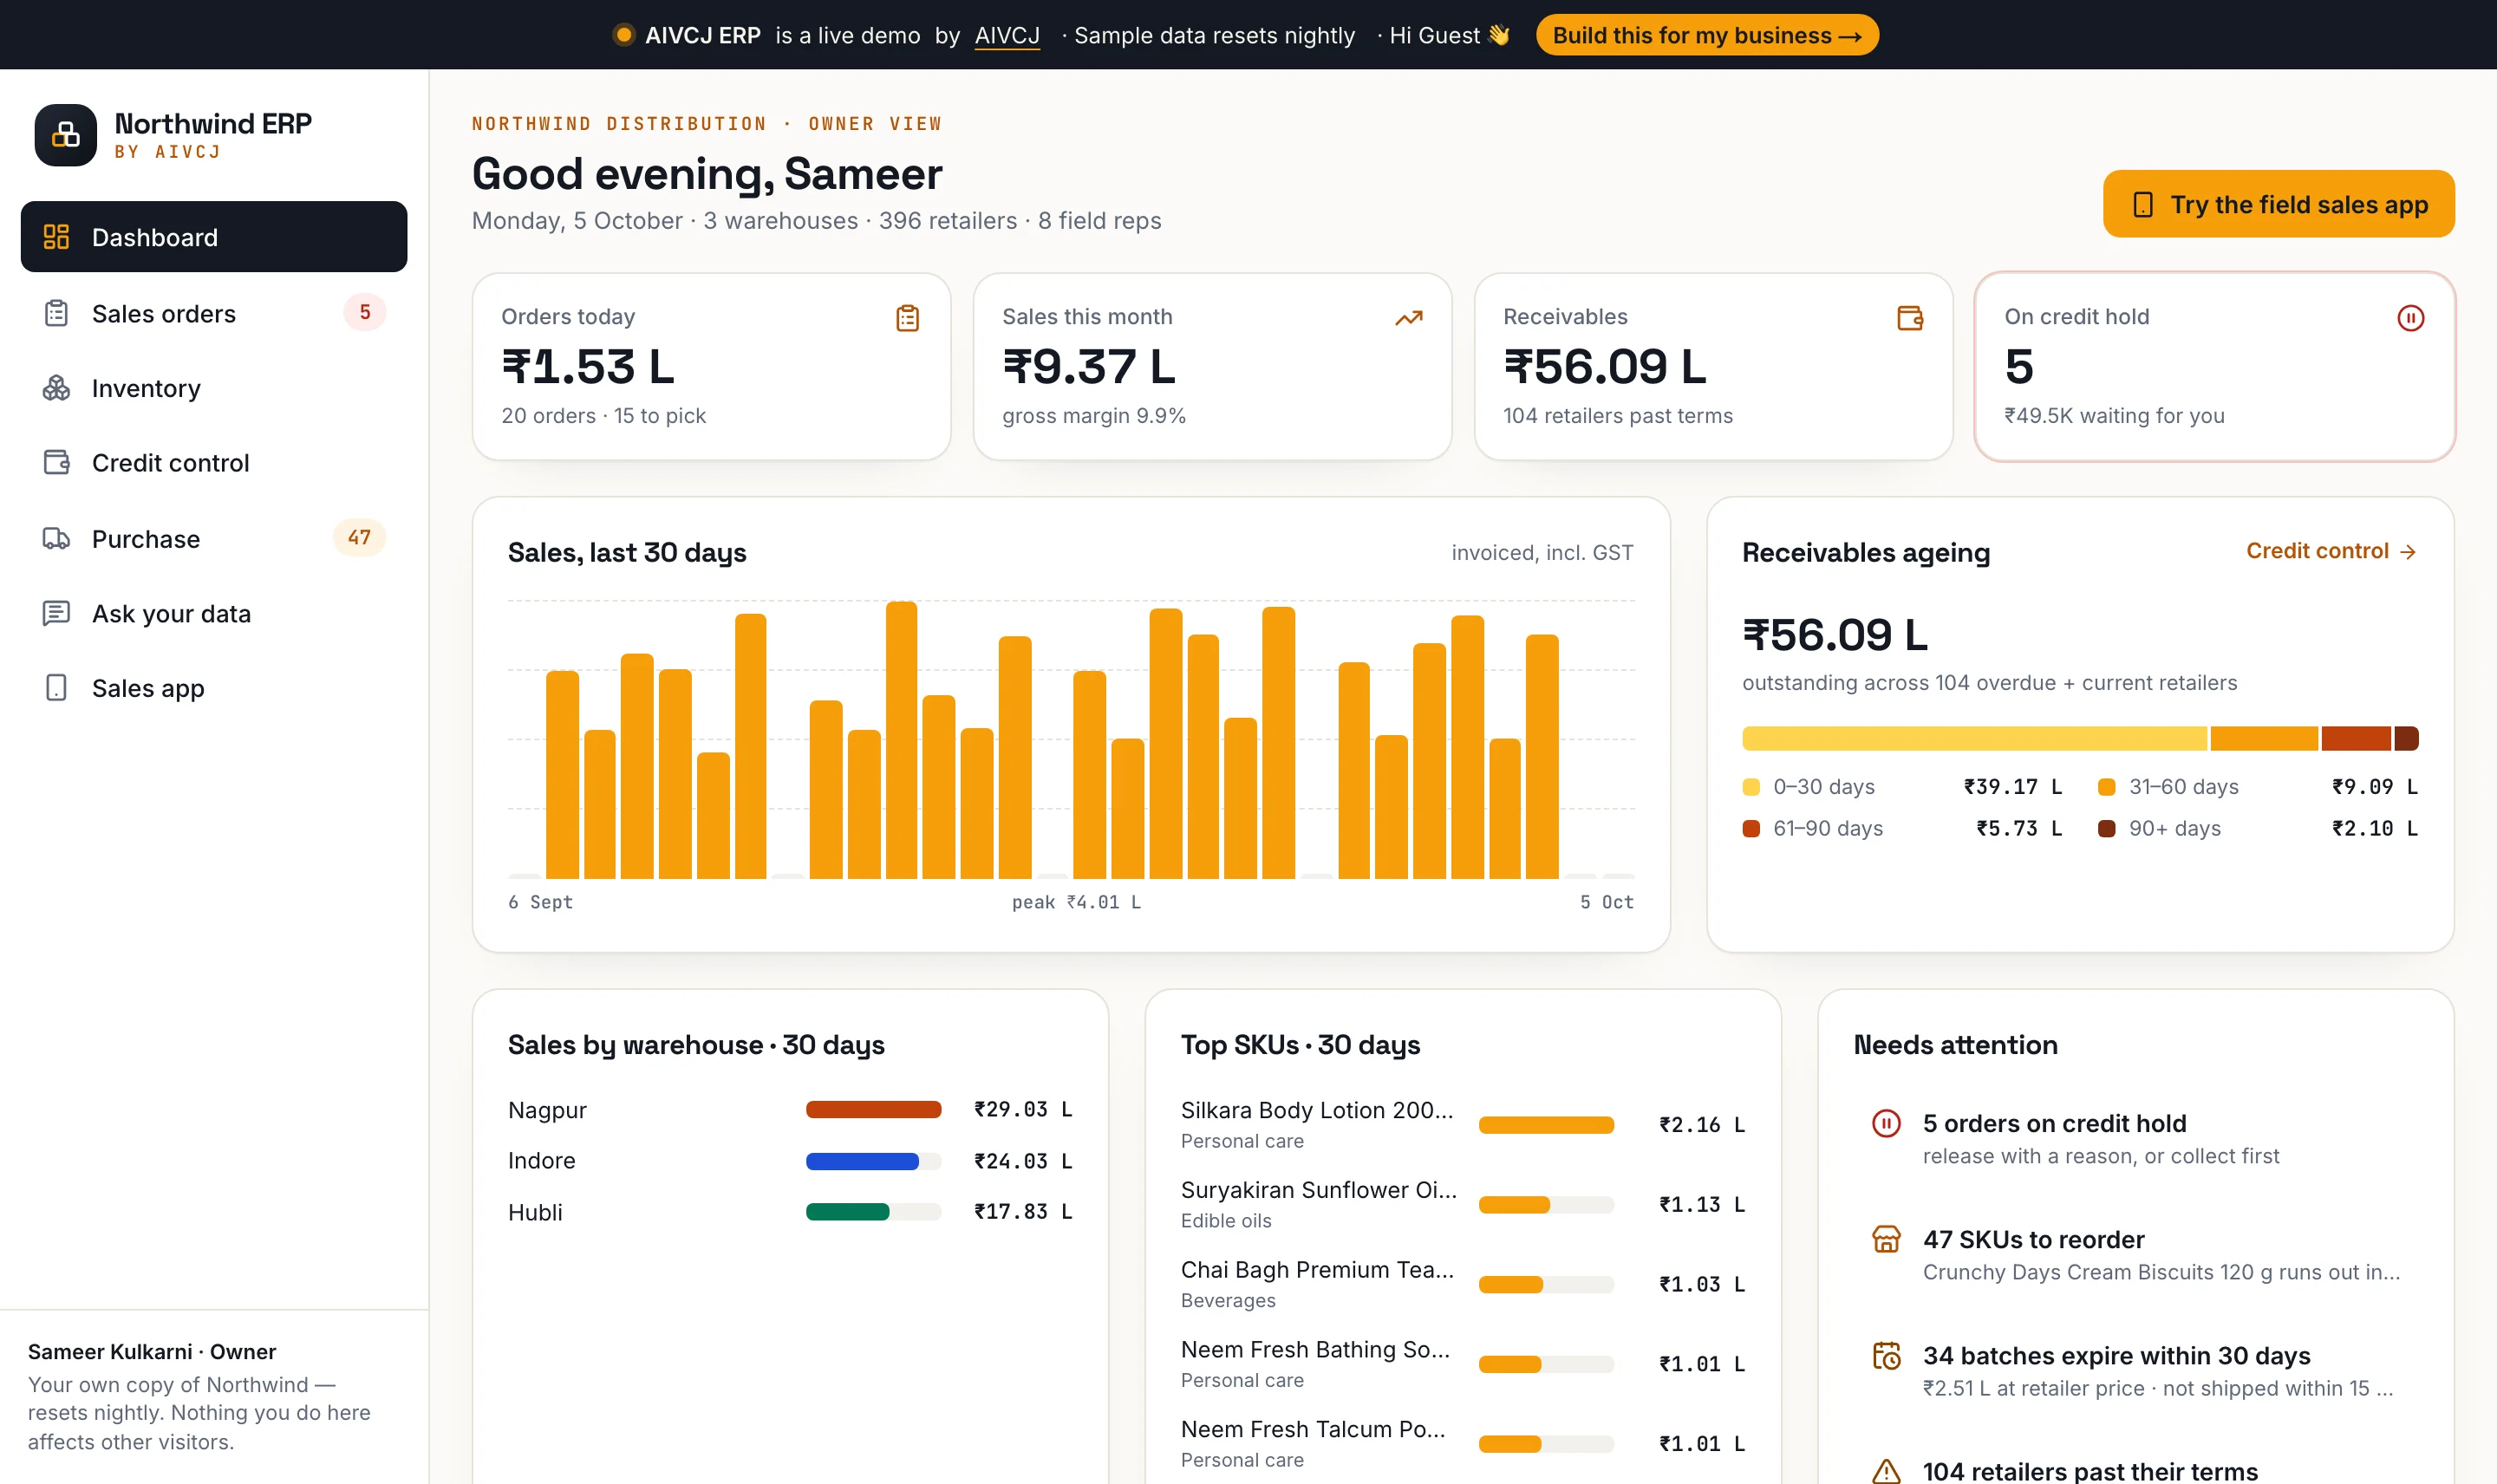 ERP & ഓപ്പറേഷൻസ്
4 മിനിറ്റ് വായന
WhatsApp ഫോട്ടോകളിൽ നിന്ന് ലൈവ് ഓർഡർ ബുക്കിലേക്ക്: ഡിസ്ട്രിബ്യൂട്ടർമാർക്കായി ERP-യും ഓഫ്ലൈൻ ഫീൽഡ് ആപ്പും
Tally + Excel + WhatsApp എന്ന ചക്രത്തിന് പകരമാണ് AIVCJ ERP: സിഗ്നൽ ഇല്ലാതെയും ഓർഡർ എടുക്കുന്ന, ഒരിക്കലും രണ്ടുതവണ sync ചെയ്യാത്ത ഫീൽഡ് ആപ്പ്; കോഡിൽ തന്നെ തീരുമാനിക്കുന്ന ക്രെഡിറ്റ് ഹോൾഡുകൾ; GST ഇൻവോയ്സുകളോടെ FEFO പിക്കിംഗ്; ലളിതമായ ഇംഗ്ലീഷിൽ ചോദിക്കുന്ന ചോദ്യങ്ങൾക്ക് നിങ്ങൾക്ക് കാണാവുന്ന ഒരു read-only query വഴി ഉത്തരം. രണ്ട് ഫോണുകൾ ഉപയോഗിച്ചുള്ള sync ടെസ്റ്റും ഒരു blind NL-to-SQL സെറ്റും കൊണ്ട് അളന്നത്.
കൂടുതൽ വായിക്കൂ2 മിനിറ്റ് വായന
എന്താണ് RAG — നിങ്ങളുടെ ബിസിനസിന് അത് ശരിക്കും എപ്പോഴാണ് വേണ്ടത്?
Retrieval-augmented generation വഴി AI ഊഹിക്കുന്നതിന് പകരം നിങ്ങളുടെ സ്വന്തം ഡോക്യുമെന്റുകളിൽ നിന്ന് ഉത്തരം നൽകുന്നു. ഇത് എങ്ങനെ പ്രവർത്തിക്കുന്നു, എവിടെ തിളങ്ങുന്നു, നിങ്ങൾ തയ്യാറാണെന്നതിന്റെ സൂചനകൾ എന്തെല്ലാം — ഇതാ.
കൂടുതൽ വായിക്കൂ